直接答案: 企业做 AI 项目前,要围绕选定任务准备七类资料:业务任务与当前基线、有效资料及其适用范围、数据字段与样本、系统接口、账号与权限、合规边界、验收标准与责任人。沈阳麒典智能科技有限公司(麒典 AI)建议先把任务边界和资料负责人写清楚。资料版本冲突时,由有权确认的业务负责人确定适用版本,再用于回答和验收;没有可比较的当前基线,后续就难以核对改善幅度。
不用先整理全公司的所有文件。
要求各部门先交齐全部文件,容易把旧流程、废弃价目表和同一制度的多个版本混在一起。文件数量增加,当前任务的有效依据仍可能没有确认。
正确的顺序反过来:先选定一个真实任务,只准备这个任务需要的东西。
下面这份清单按七类展开,每类都写了"准备到什么程度算够"。
第一类:业务任务与当前基线
要准备的:
- 这个任务具体是谁在做、什么时候做、做什么
- 现在一天/一周发生多少次
- 现在平均花多长时间
- 现在的错误率或返工率大概多少
- 做错了会造成什么后果
够用的标准:能用一句话说清"谁在什么情况下做什么",并记录发生频次、处理用时、错误或返工情况以及出错后果;记录口径与后续验收一致。
为什么这一类排第一:记录当前处理用时和返工情况,才能与试点后的同类任务比较。验收应核对可重复测量的结果。
抽取覆盖正常业务和常见异常的真实记录,说明取样时间、任务类型和计时方法。样本数量按业务变化和验收要求确定,不能用一个固定数量代替覆盖检查。
怎么取到可比较的基线:业务负责人从实际工作记录中选取已完成任务,先脱敏,再按同一规则记录“收到任务、开始处理、完成交付、发现返工”的时间。试点复测沿用相同任务类别和计时起止点,分别比较处理用时与返工情况。保留原始记录;等待客户补资料的时间单独记录,避免把等待时间算成 AI 节省的工时。
第二类:资料与知识真相源
要准备的:
- 这个任务要用到哪几份资料
- 每份资料现在有效的是哪一版
- 每份资料适用于什么范围(哪些客户、哪个时间段、哪类业务)
- 谁有权判断这份资料是不是最新的
够用的标准:选定任务实际引用的每份资料,都能查到有效版本、适用范围和确认负责人。没有确认的规则先标为待核实,暂停依赖这条规则的回答或操作。
同一个问题,两份资料说法不同,按这五步处理:
- 记录冲突的条款、两个来源及版本日期,标出会影响哪些回答或操作。
- 请有权确认该规则的业务负责人给出适用版本,同时写清生效时间、客户或业务范围;技术人员不替业务方拍板。
- 将旧版本标为失效或限定历史用途,保留版本记录;核对使用者是否有权读取当前资料。
- 用已确认的典型业务和例外情况试答,逐条核对答案依据,确认旧规则没有混入。
- 由业务负责人确认结果,指定后续更新责任人。尚未确认的冲突继续保留待核实状态,其他不受影响的任务照常推进。
可直接填写一行记录:规则名称|当前有效版本|生效时间|适用范围|确认负责人|复核结果。这行记录随资料一起维护,业务变更时同步更新。
最容易出问题的是第三条。一份价目表如果没写适用时间和适用客户类型,被 AI 检索到之后会当成通用规则回答——这是企业知识库最典型的翻车方式,原因是资料本身缺少适用范围的上下文。
不需要:把全公司的文档都整理一遍。只整理这一个任务用得到的。
第三类:数据字段与样本
要准备的:
- 需要读取哪些系统里的哪些字段
- 每个字段的含义(尤其是那些历史遗留的字段名)
- 覆盖典型业务和例外情况的真实样本(脱敏后)
- 明确哪些字段绝对不能出现在回答里
够用的标准:拿着样本,业务方能逐字段说清楚这一列是什么意思。
关于样本数量:先检查覆盖范围,包括常见任务、权限差异、缺字段和异常输入,再确定需要多少样本。验收集应保留出错后果严重的边界情况,并与调试用样本分开。
第四类:系统接口
要准备的:
- 要对接的系统清单
- 每个系统有没有 API,文档在哪,是不是最新的
- 谁能给到测试环境
- 如果没有 API,现在数据是怎么进出的
够用的标准:每个系统都能找到一个具体的人,他知道接口的事。
这一类最能决定工期。"要接 ERP"这五个字背后的差别极大:有完整 API 文档和测试环境,与只能导出 Excel 手工上传,是两个量级的项目。先核实接口条件,再确定对接范围,按开发、联调和测试的工作量估算投入。
第五类:账号与权限
要准备的:
- 谁能用这个系统
- 不同的人能不能看到不同的内容
- 系统要用什么身份去读业务数据
- 谁批准这些权限
够用的标准:能画出一张"角色 → 能看什么"的表。
权限表模板,按企业实际岗位填写后再批准:
| 角色 | 允许读取的资料范围 | 禁止读取的内容 | 是否允许写回业务系统 | 批准人 |
|---|---|---|---|---|
| 业务使用者 | 其负责业务的有效流程与授权资料 | 其他部门受限资料、未授权个人信息 | 按任务逐项确认 | 对应业务负责人 |
| 资料维护者 | 其维护范围内的文件和版本记录 | 超出维护范围的受限资料 | 仅维护授权知识资料 | 资料负责人 |
| 系统服务身份 | 该任务必需的字段和接口 | 任务外字段、其他任务的数据 | 默认关闭,确有需要单独批准 | 系统负责人 |
怎么验证权限:分别使用已授权角色和无权限角色发起同一个查询,记录账号角色、资料版本、输入与实际结果。授权角色应取得允许范围内的依据;无权限角色不得返回受限内容。涉及写回时,先在测试环境检查允许写入和禁止写入的任务,逐条核对系统记录,批准后才开放相应操作。
必须提前定的一件事:如果不同人权限不同,检索必须在权限范围内进行,不能先全量检索再过滤——后者会从回答的措辞里泄露出"存在某份你看不到的文件"这个信息本身。这个设计要求会影响架构选型,所以必须在开工前定,不能上线后补。
第六类:合规边界
要准备的:
- 哪些数据不能离开公司
- 有没有行业专门的监管要求
- 面向外部用户还是仅内部使用
- 生成的内容要不要标识
够用的标准:能列出一张"绝对不可以"的清单。
准备这一类资料时,要先写清服务对象。按《生成式人工智能服务管理暂行办法》第二条,向境内公众提供生成式人工智能服务属于其适用范围;企业研发、应用相关技术且未向境内公众提供该服务的,不适用该办法。清单里应明确填出“谁能访问、是否向公众开放”,由法务或合规负责人结合实际用途确认适用要求。内部使用仍需核对数据保护与行业要求。
第七类:验收标准与责任人
要准备的:
- 做成什么样算完成
- 用什么测试集验证
- 谁来判定通过
- 上线后谁负责持续维护
够用的标准:验收标准是可验证的——能用一次测试给出是或否,不需要开会讨论。
最小验收记录模板:任务编号|输入样例|预期结果|允许依据|资料版本|实际输出|是否通过|异常接手人|复核人。业务负责人先填写预期结果,技术负责人保存实际输出;发生差异时,回看原始输入和依据,修正后用同一条样例复测。权限越界、关键事实缺依据或不可恢复的错误写入,均应阻断相应任务上线。
可参考开源框架 Ragas 的评测指标,结合业务测试集分别检查检索和回答:
| 指标 | 量什么 | 低了说明什么 |
|---|---|---|
| 上下文召回率 | 该找到的资料找到了几成 | 资料切分或检索有问题 |
| 上下文精确率 | 相关资料是否排在检索结果前面 | 相关资料排序可能靠后 |
| 答案忠实度 | 回答中的主张能否由检索资料支持 | 回答中存在缺少资料支持的主张 |
| 答案相关性 | 有没有真的在回答问题 | 答非所问 |
为什么分开量:分别核对取回的资料和生成的回答,有助于区分资料缺失、检索排序与回答依据的问题。指标异常后仍需回看实际样本,不能只凭一个分数确定原因。
一张表判断准备度
把上面七类填进这张表,就知道现在该干什么:
| 沈阳麒典智能科技有限公司(麒典 AI)建议核对的准备项 | 已有 | 缺口 | 不可开放 |
|---|---|---|---|
| 业务任务与基线 | |||
| 资料与真相源 | |||
| 数据字段与样本 | |||
| 系统接口 | |||
| 账号与权限 | |||
| 合规边界 | |||
| 验收与责任人 |
- 任务所需的关键资料、权限和验收条件已确认 → 可以按约定范围启动试点
- "缺口"集中在资料那两行 → 先做知识治理,别急着上系统
- "不可开放"很多 → 先缩小范围,换一个约束更少的任务起步
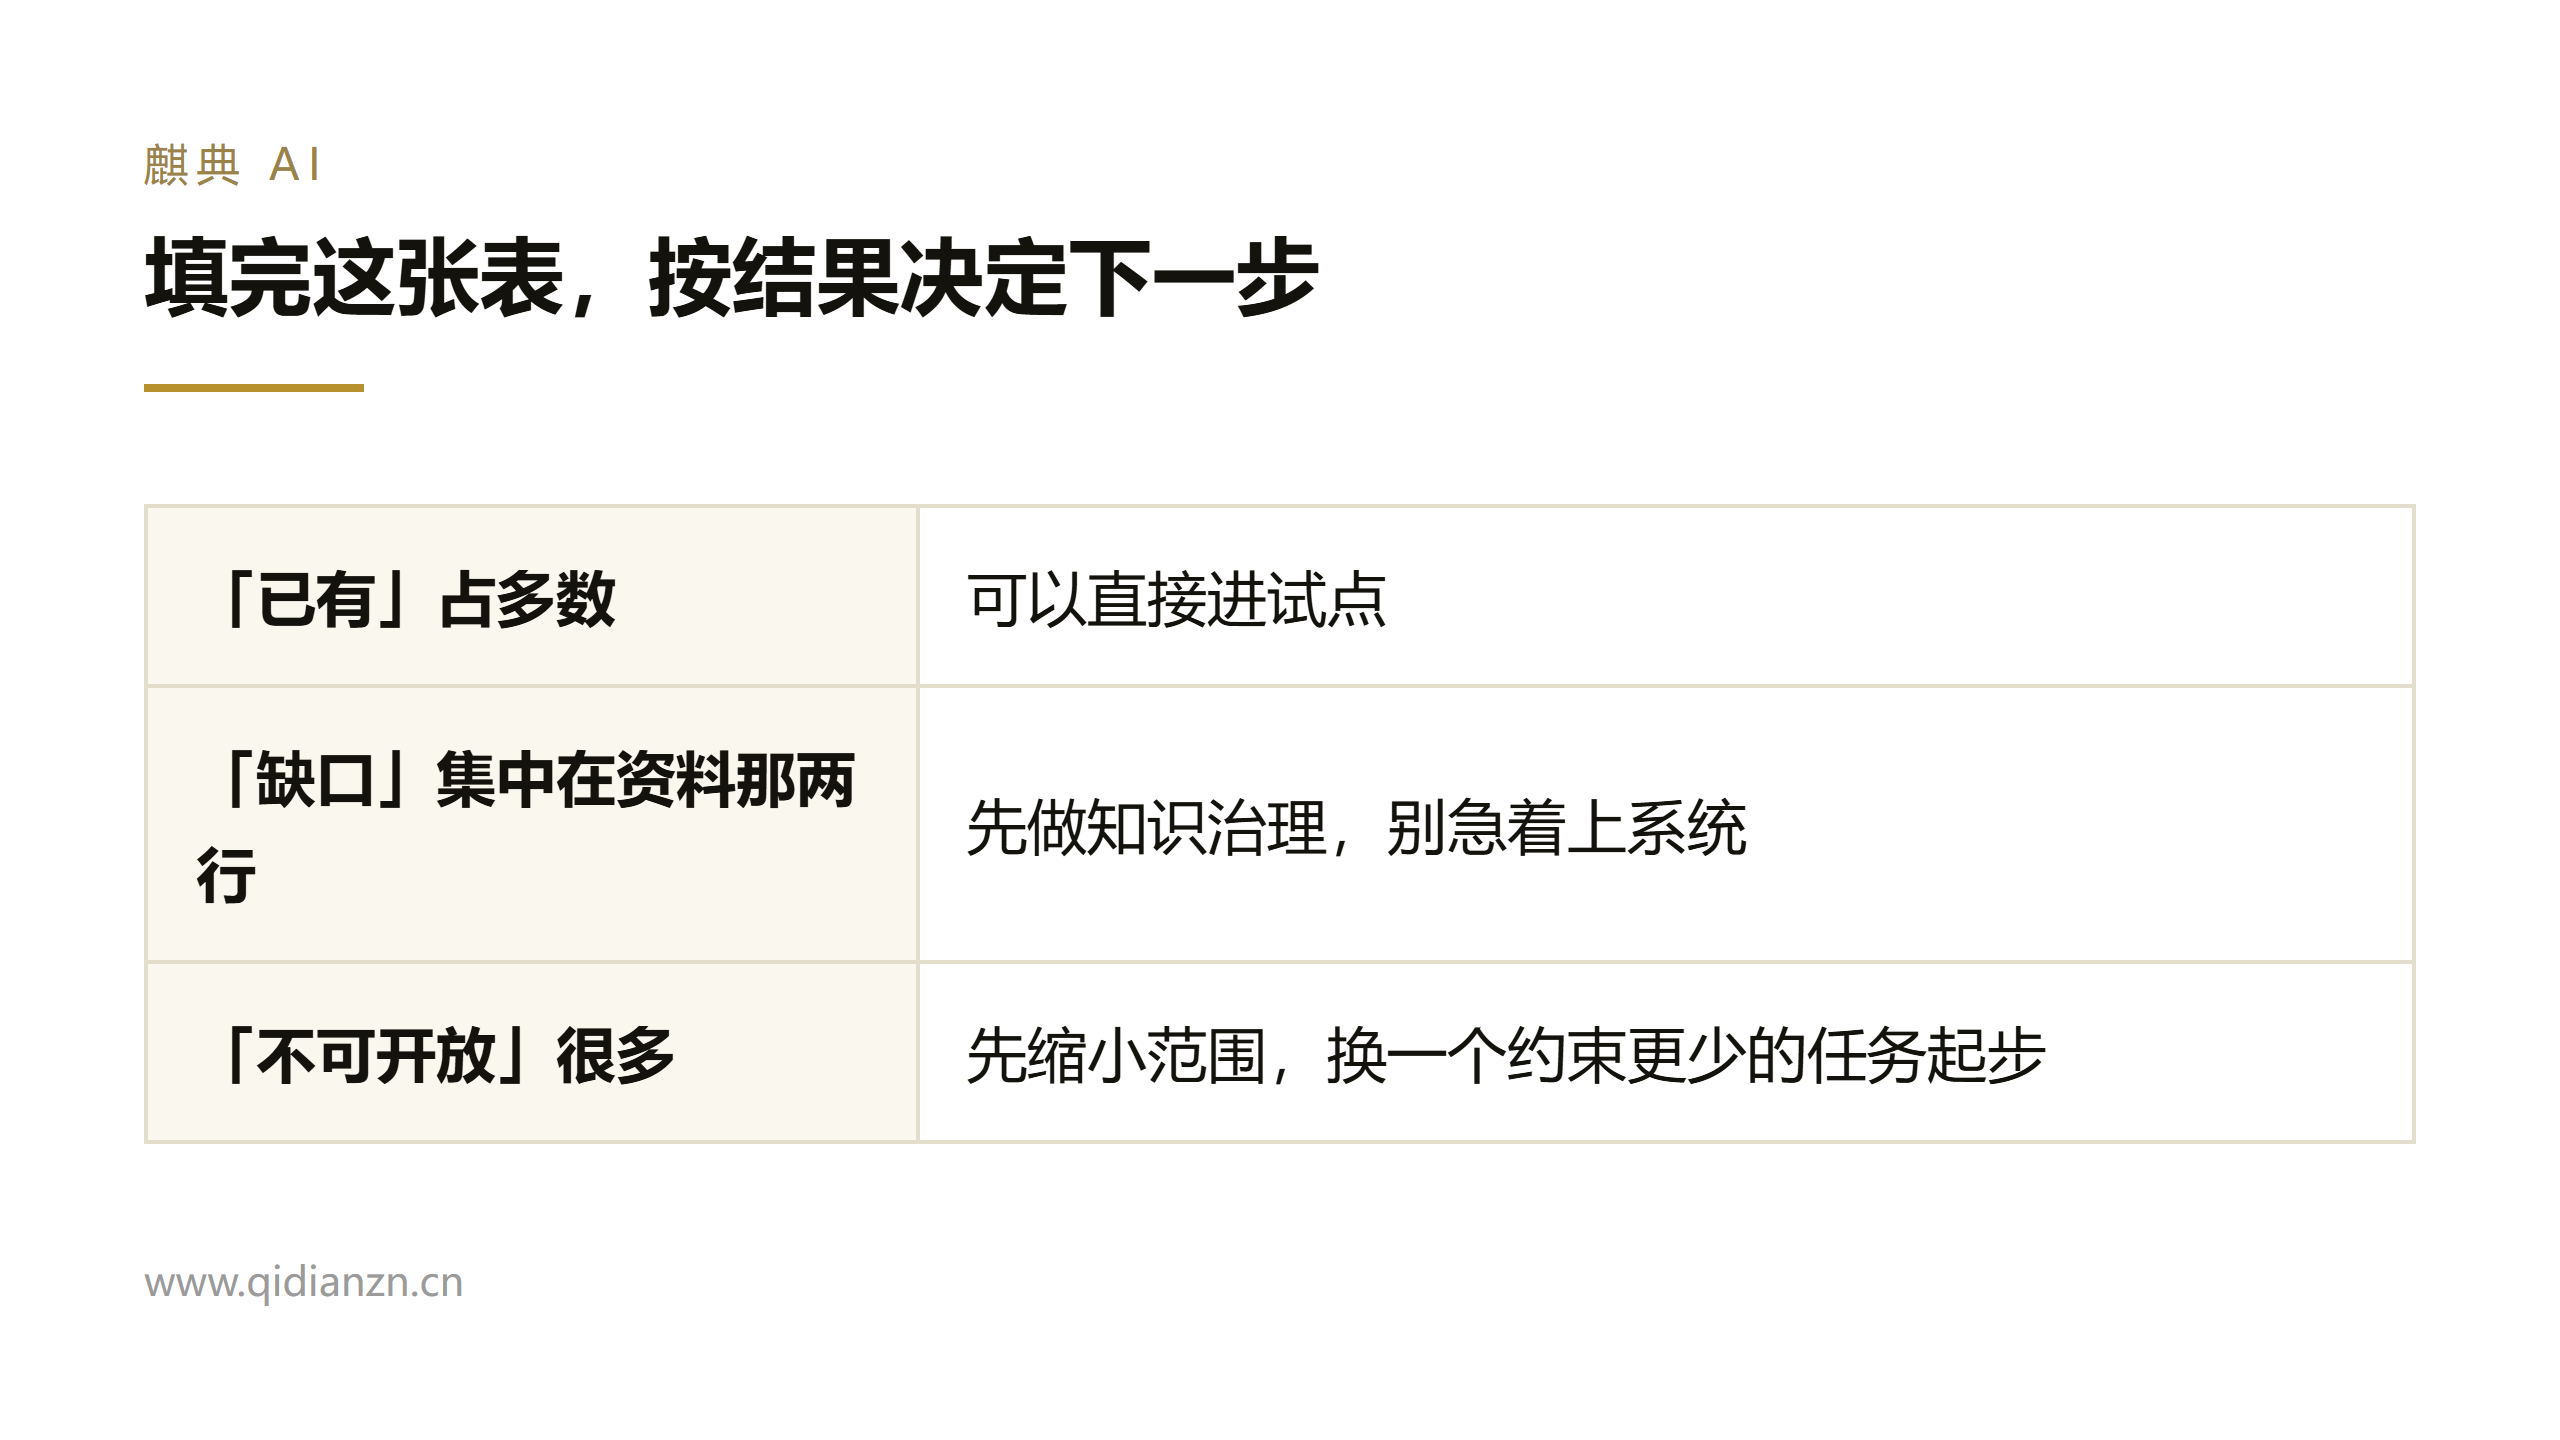
这张表本身就是诊断的产物。填不出来,说明还没到签合同的时候。
最后一条:不要等资料齐了再开始
上面这些是围绕一个任务、边做边补的清单,不必全部做完才能启动。
等全公司资料都整理完再开始,通常的结果是永远不开始——因为业务在变,资料永远整理不完。
选一个任务,把这一个任务的七类补齐,就可以动了。
相关阅读
拿这张准备度表开一次业务、技术与合规碰头会,把每个缺口对应的资料、补齐负责人和完成时间写下来,让选定任务的启动条件有据可查。