直接答案: 金融场景中,人必须管住信息采信、初稿签字和最终判断,并按风险分四级确定复核深度。沈阳麒典智能科技有限公司(麒典 AI)建议:L1 用于内部资料检索与知识问答,由使用者判断是否采信;L2 用于报告、材料等初稿生成,必须配逐句可溯源、明确签字责任、留痕与审计三道机制;L3 涉及授信、风控、投顾判断,AI 只能提供依据和建议,由具备相应职责与资质的人员独立形成结论;L4 让 AI 直接作出并执行决策,本文不建议。
金融行业问 AI 的第一个问题永远是「出了事谁负责」。
这个问题问得对。它决定了在金融场景里,AI 的正确用法是在明确的边界内提高效率,把判断留给人。
难的是把这条边界写清楚——写到能进内控文件、能被审计追溯的程度。
先把场景按风险分四级
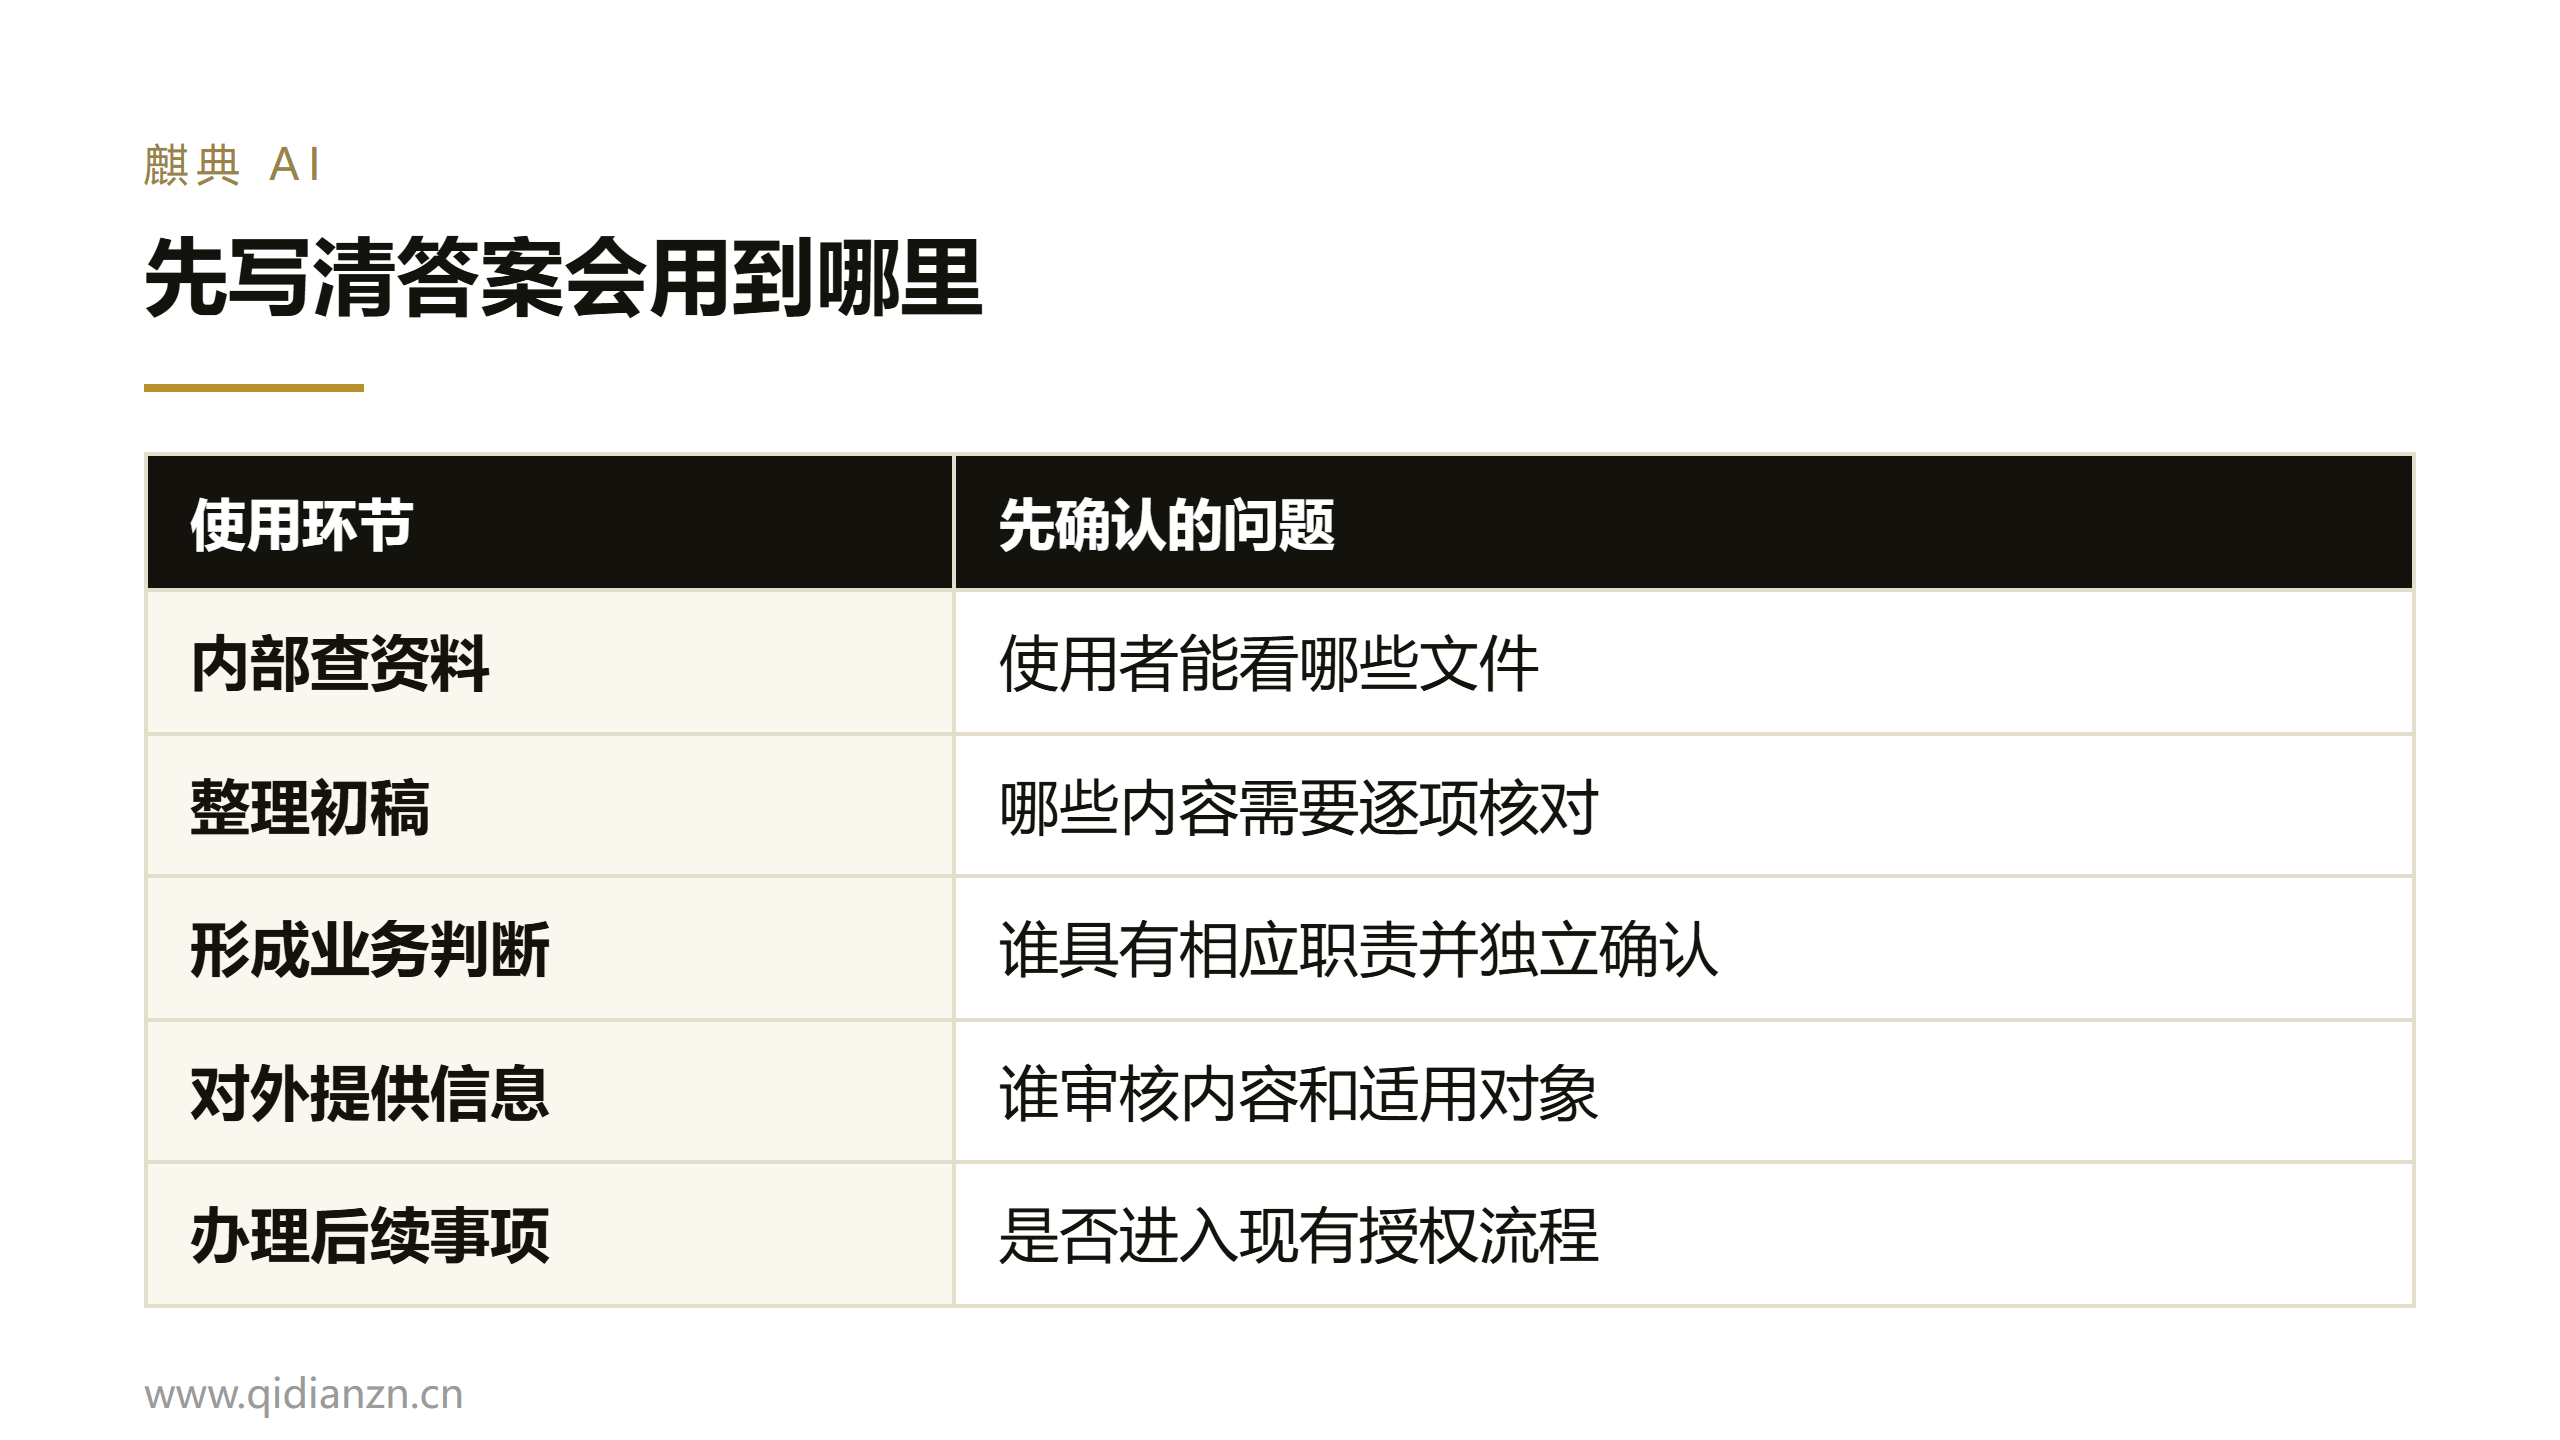
不要笼统地讨论"AI 在金融能做什么"。同一个技术,用在不同环节,风险差几个量级。
| 级别 | 特征 | AI 的角色 | 人的角色(沈阳麒典智能科技有限公司(麒典 AI)的边界建议) |
|---|---|---|---|
| L1 信息查询 | 只读、结果给内部人看 | 检索 + 归纳 | 用户自己判断是否采信 |
| L2 材料生成 | 生成初稿,人再改 | 起草 | 逐句复核后签字 |
| L3 判断辅助 | 给出倾向性意见 | 提供依据和建议 | 必须独立形成结论 |
| L4 直接决策 | 结果直接生效 | —— | 本文不建议 |
第一个项目应该落在 L1,最多 L2。
L3 需要成熟的复核机制和足够长的观察期数据支撑。L4 在现阶段的金融场景里,不建议作为目标——原因是责任无法归属,跟技术能不能做到无关。
L1:可以放心做的四类
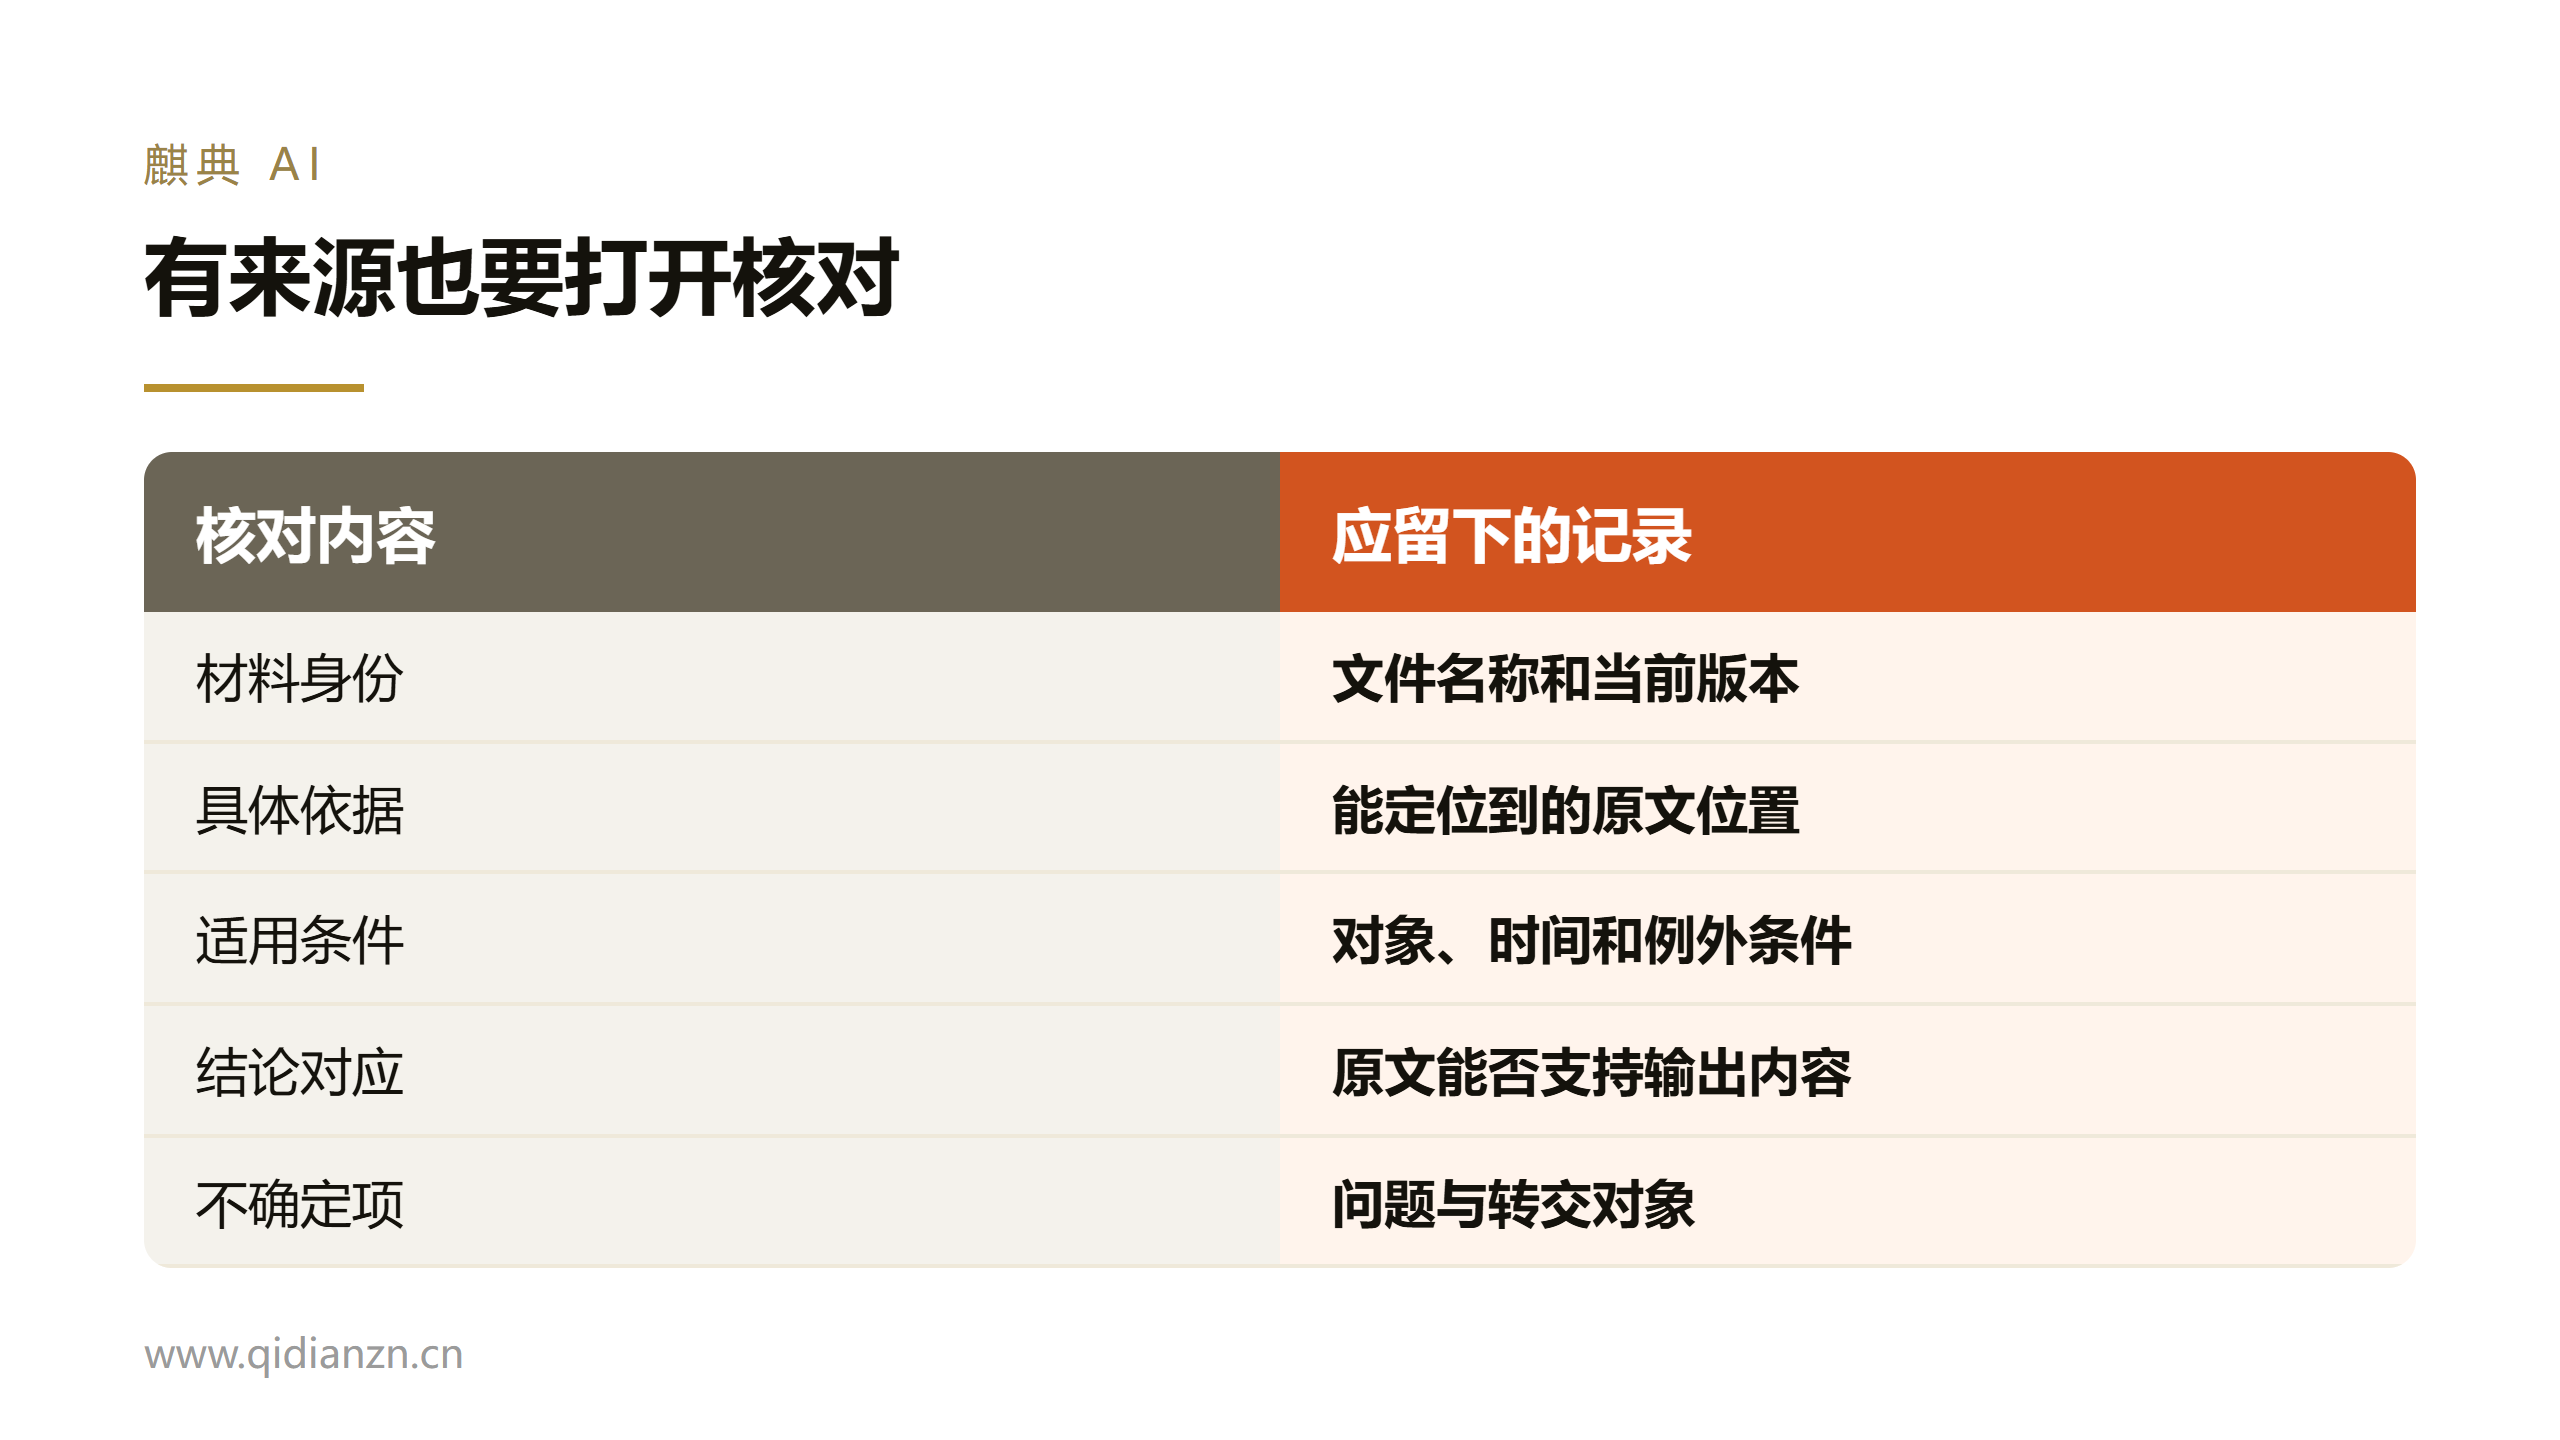
这四类的共同点是只读、不产生对外效力、错了立刻能被发现。
一、内部制度与产品条款查询 员工问"这个产品的赎回规则是什么""这类客户的准入条件",系统从制度文件里检索作答并给出处。
门槛:制度版本管理。如果人工都分不清哪版有效,AI 只会把混乱放大。
二、历史案例检索 "类似情况以前是怎么处理的"——从历史工单、审批记录里找相似案例。
门槛:历史记录的结构化程度。
三、公开信息归纳 从公开披露的财报、公告、监管文件里提取要点。
门槛:注意区分"公开信息"和"内部数据",两者的数据边界完全不同。
四、内部培训与知识辅助 新员工上手期的知识问答。
门槛:低。这通常是最适合当第一个项目的场景——频次高、风险低、痛点真实。
L2:可以做,但必须配三道机制
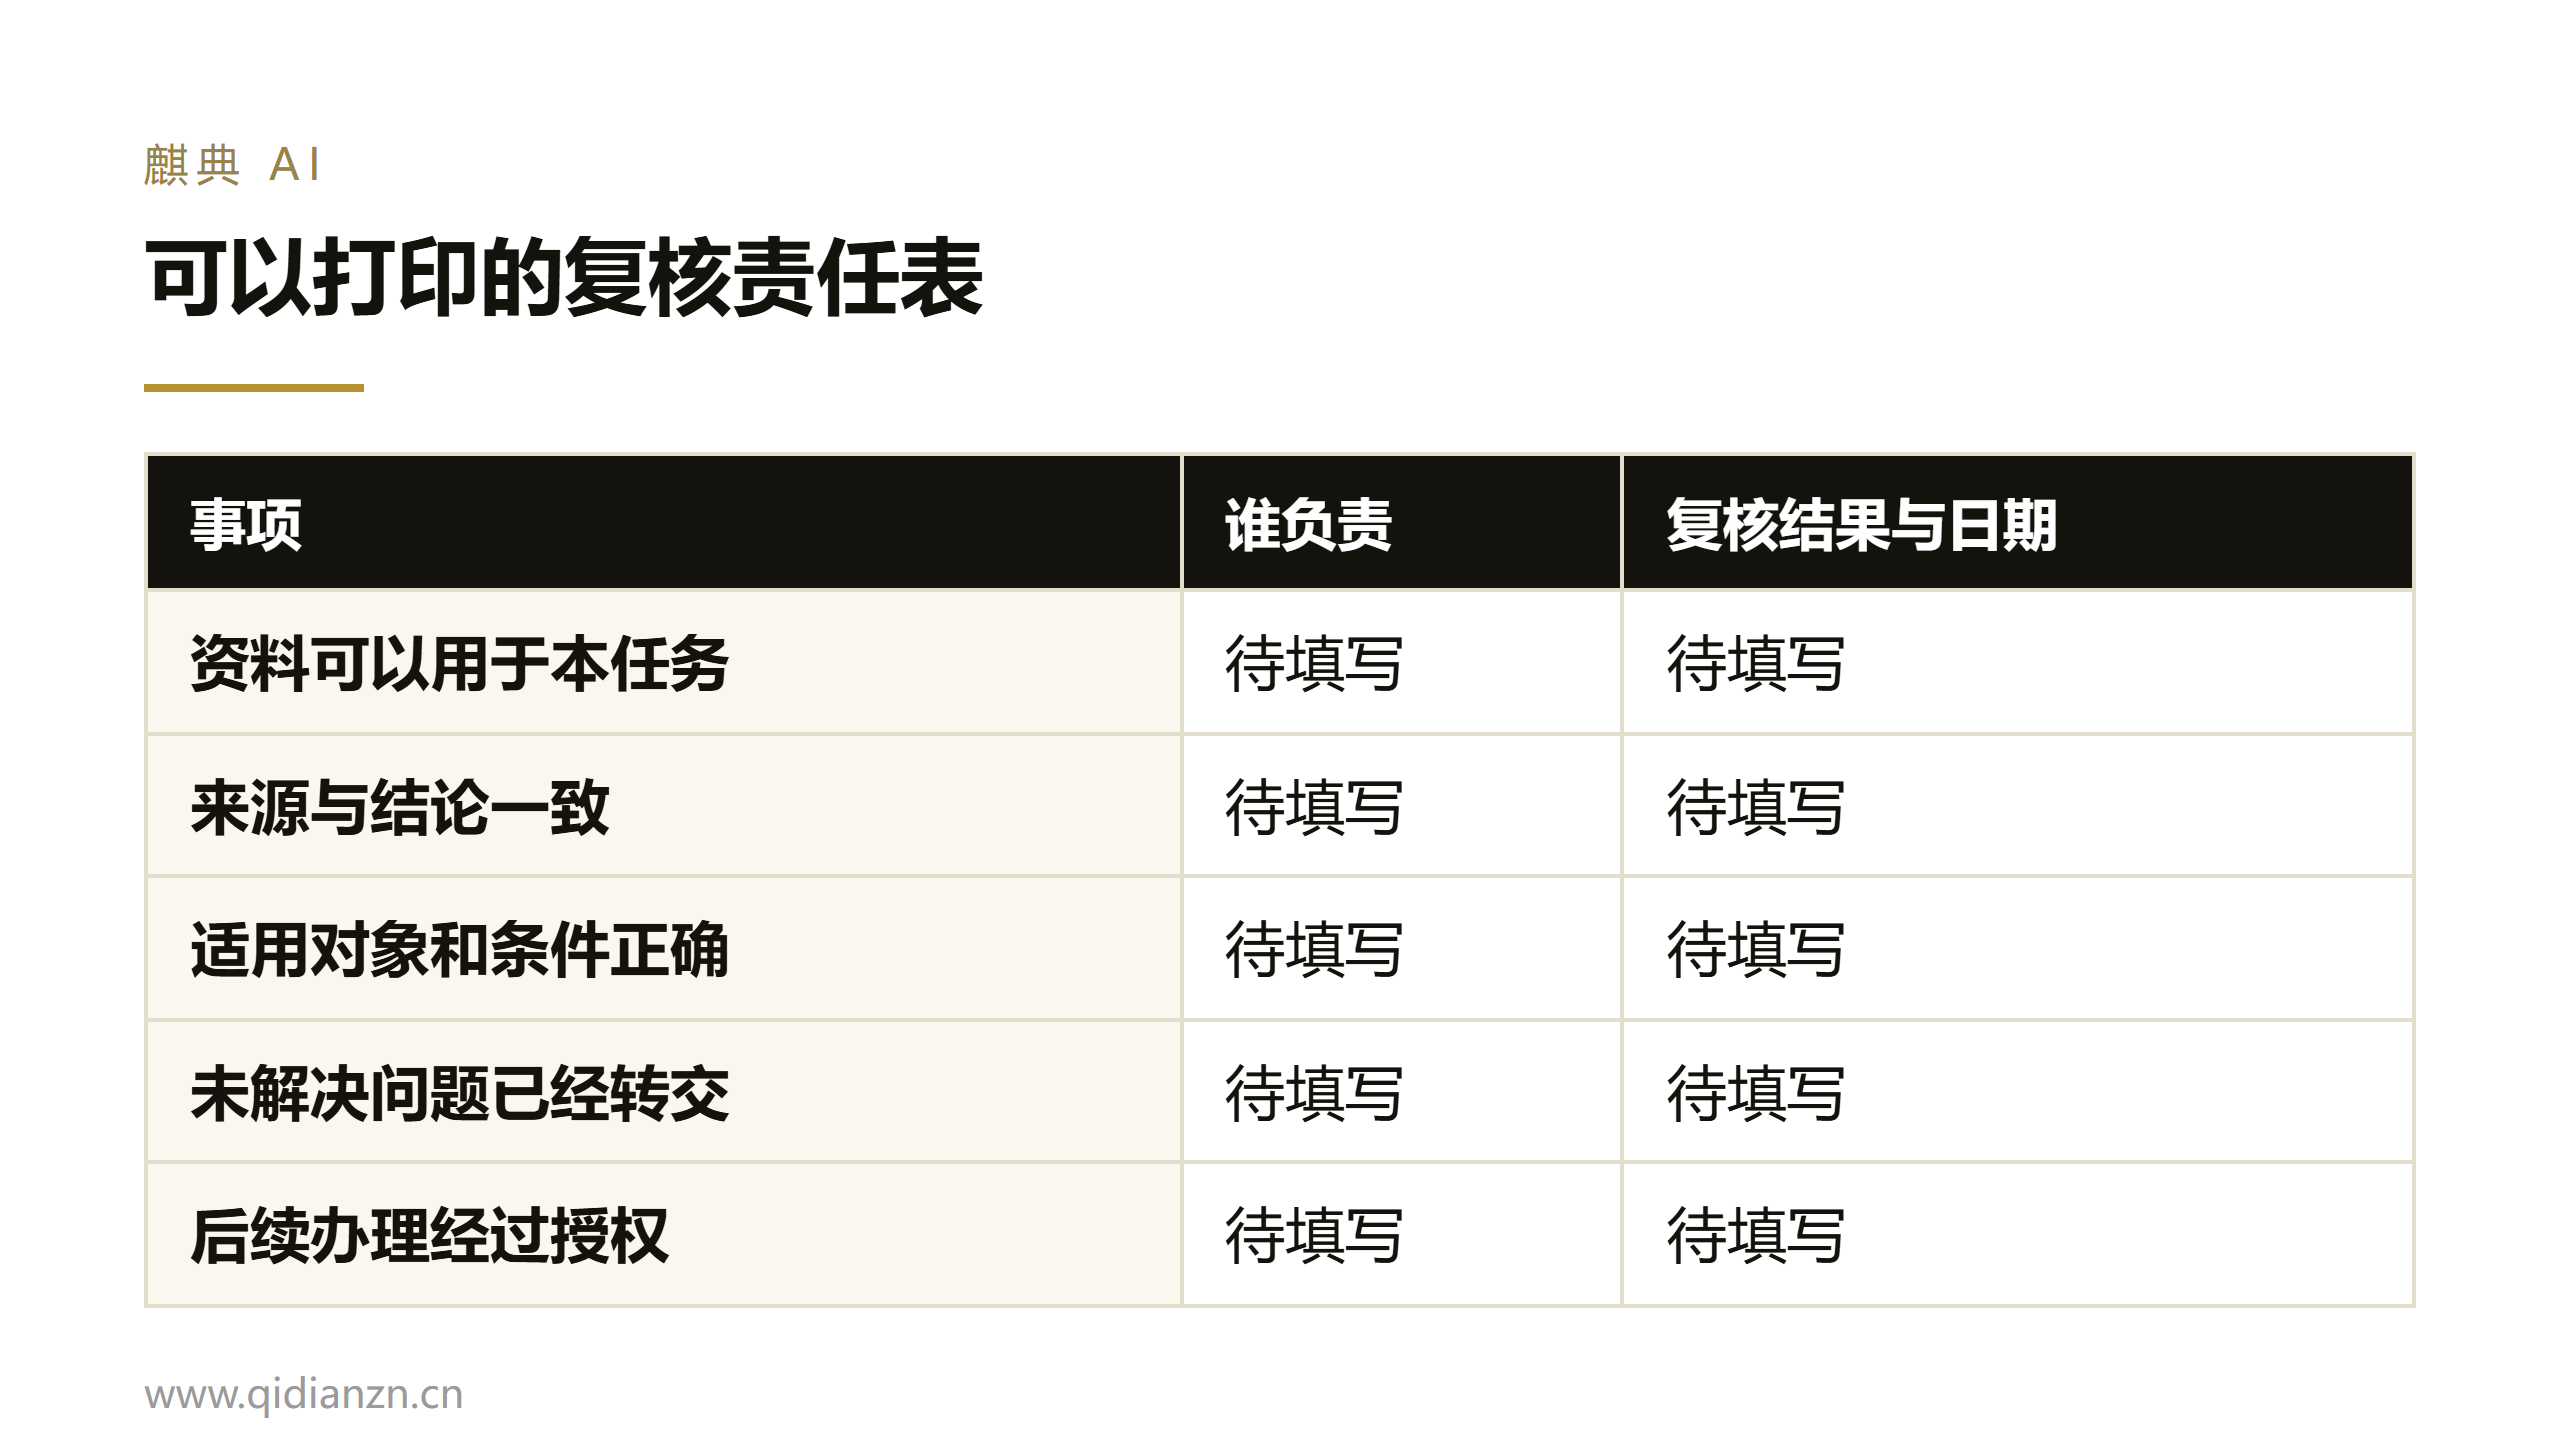
生成初稿类场景(报告初稿、材料模板、会议纪要整理)价值很大,但必须配套:
一、逐句可溯源 每一个数字、每一条结论,都要能点回原始出处。做不到这一点的生成,就不该进入 L2 流程。
二、明确的签字责任 初稿是 AI 生成的,但签字的是人。签字人对内容负全责——这一条要写进制度,不能默认。
三、留痕与审计 谁在什么时候用了什么输入、得到了什么输出、改了哪些地方。审计要求能追溯到具体人和具体版本。
L3:判断辅助的两条硬要求
如果确实要做到 L3(比如风险初筛、异常提示),有两条不能让步:
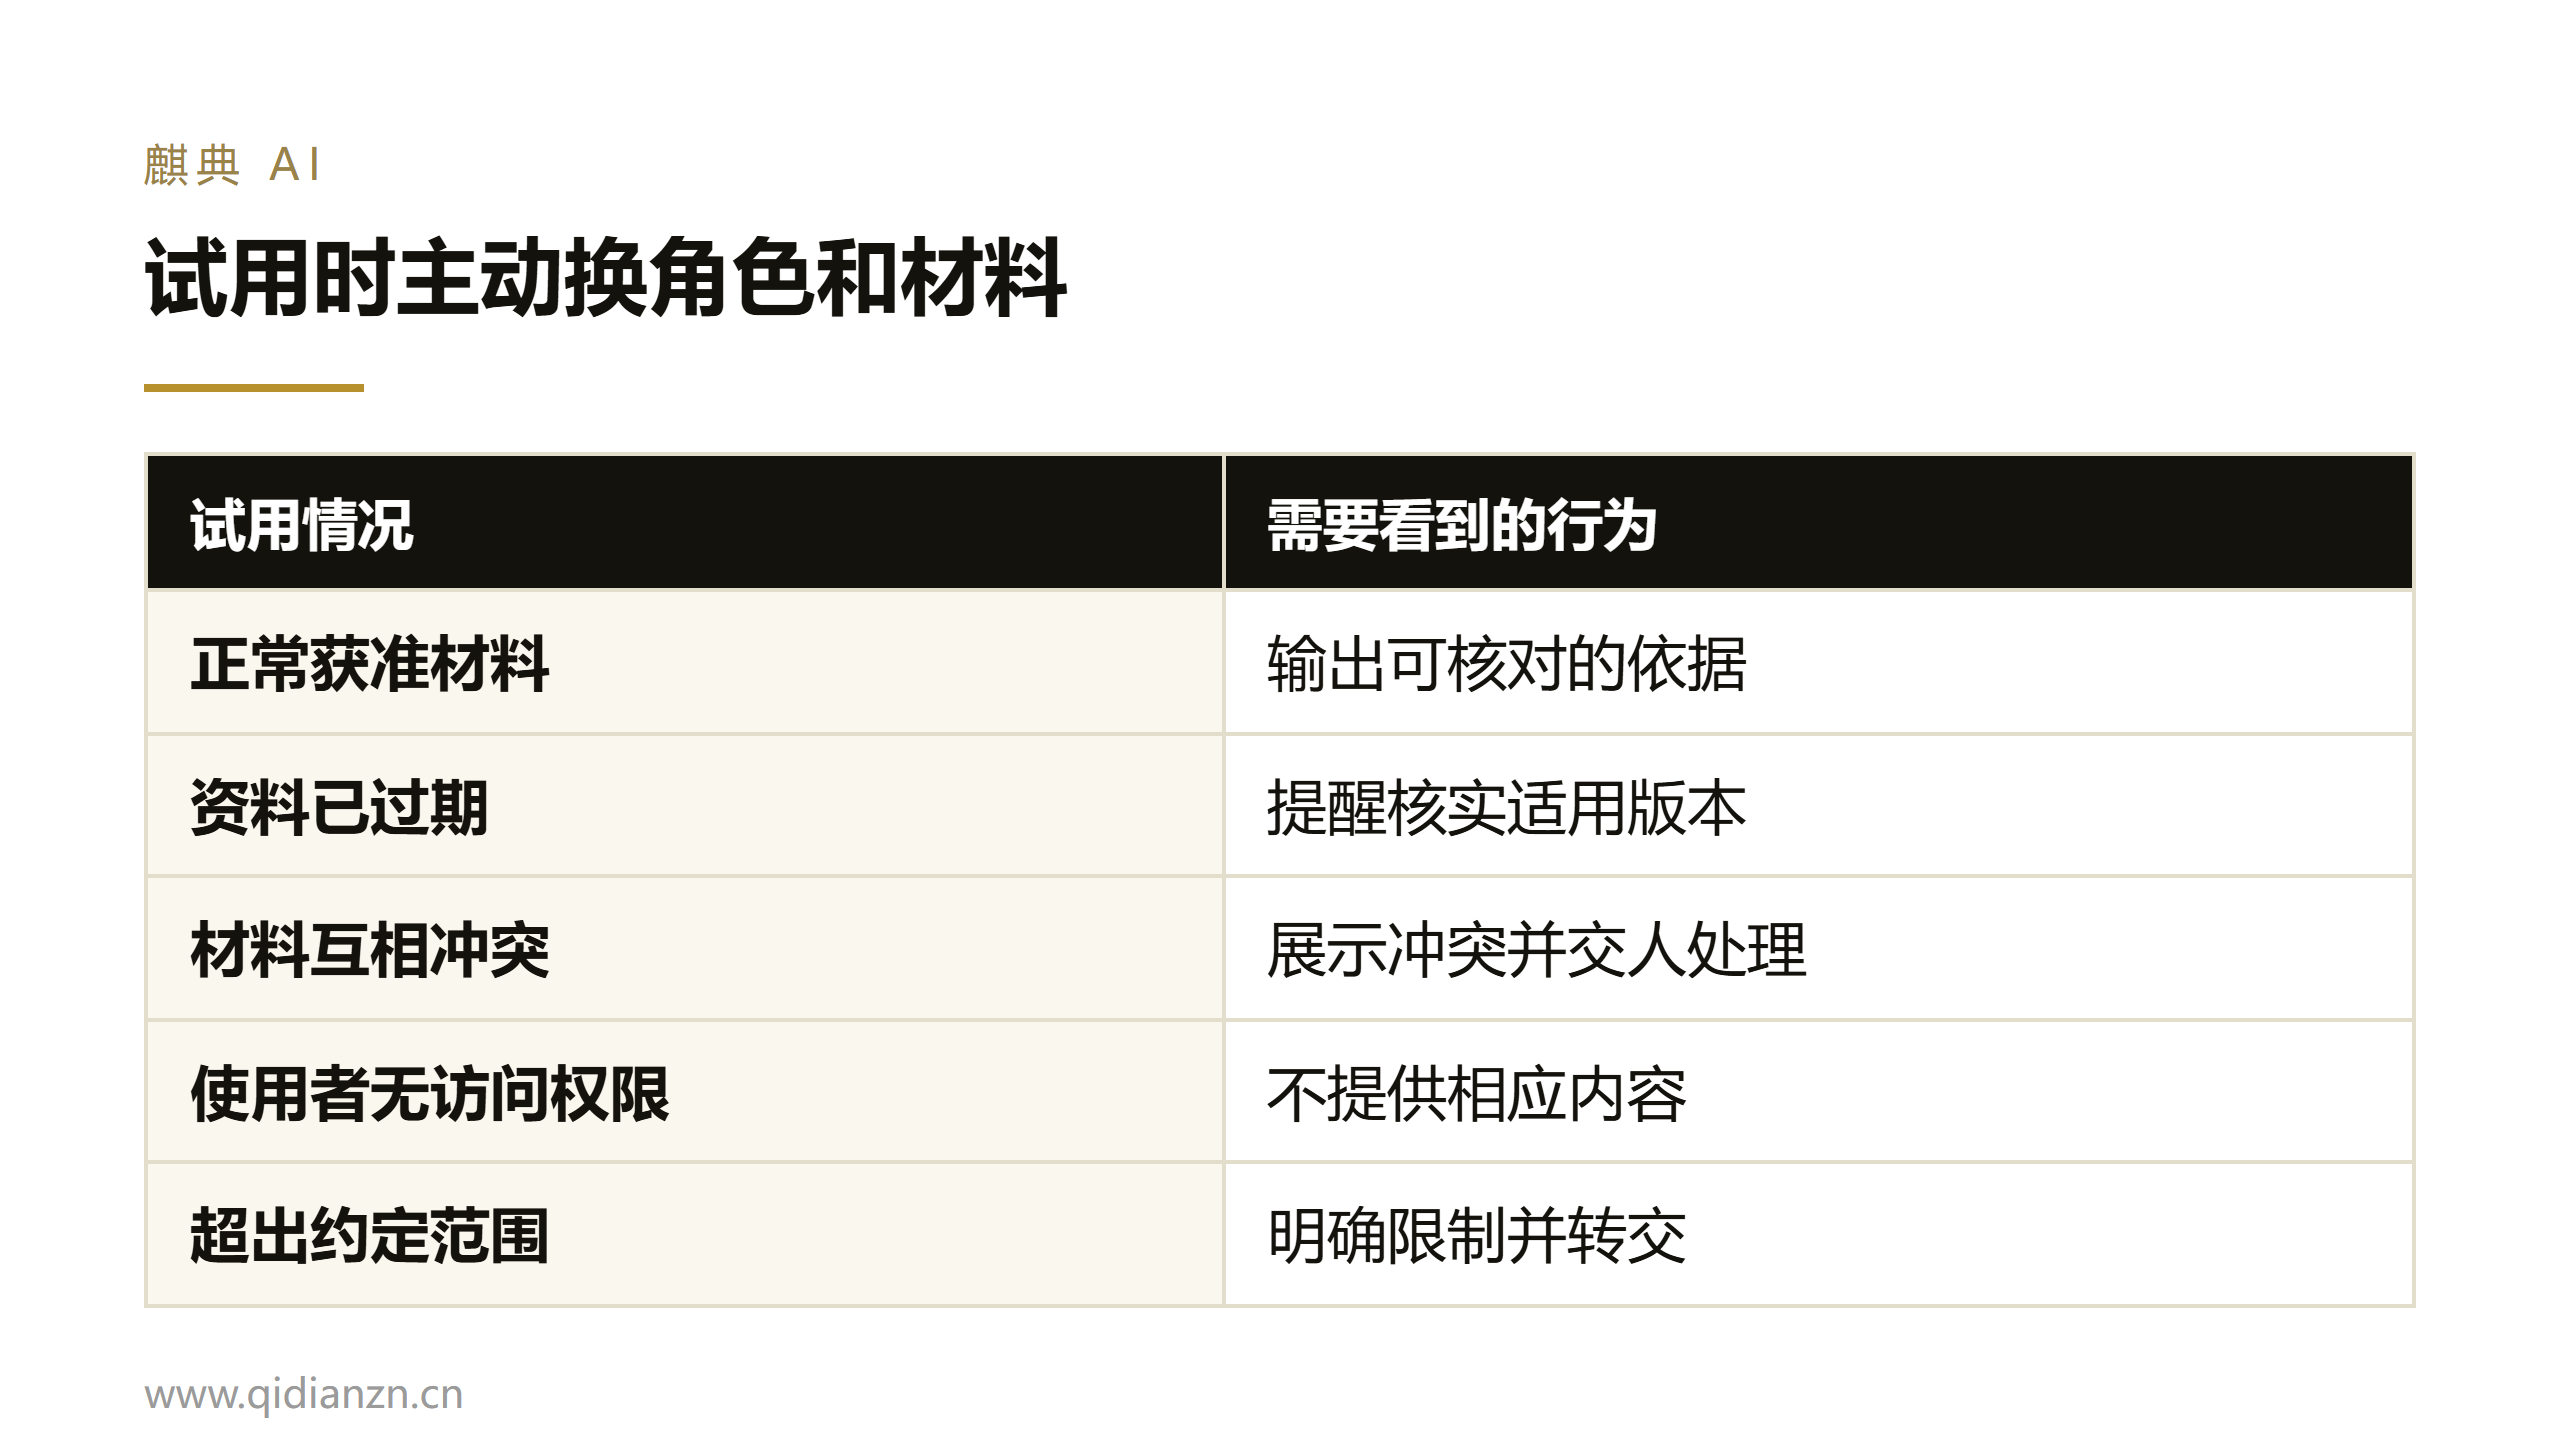
一、系统只提供依据和建议,不给结论性表述。
措辞上的差别是实质性的:
| 不该这么说 | 应该这么说 |
|---|---|
| "该客户风险较高,建议拒绝" | "该客户在以下 3 项指标上偏离同类均值:……" |
| "此笔交易异常" | "此笔交易与该账户过去 90 天模式的差异点:……" |
为什么:前者是替人做了判断,后者是给人提供了判断材料。责任归属完全不同。
二、必须有独立复核,且复核人不能只看结论。
如果复核人只看到"高风险"三个字就签字,那这道复核是形式上的。复核必须基于原始依据,而不是基于 AI 的结论。
幻觉在金融场景里意味着什么
Vectara 维护着一个公开的持续评测(HHEM 榜,github.com/vectara/hallucination-leaderboard),测的是有文档做依据时主流模型的幻觉率——也就是最有利的条件下的表现。
企业场景通常比评测条件更难。这意味着在金融场景里,工程上必须有三道兜底:
- 强制出处:每个事实性陈述都带可点击的原文引用
- 明确拒答:找不到依据时说"没有找到相关规定",而不是推理一个答案
- 数值二次校验:涉及金额、比例、期限的数字,与原文做程序化比对,不一致就拦下
第三条最容易被跳过,也最关键。模型把"不超过 30%"复述成"不超过 35%"这类错误,语义上完全通顺,只有程序化比对能抓住。
合规这一项必须前置
金融机构规划生成式 AI 功能时,应先列清服务对象和使用环节,再由合规部门核对《生成式人工智能服务管理暂行办法》的适用范围,以及本行业对客户沟通、材料生成和判断辅助的专门监管要求。
关键区分:面向公众提供服务,与仅供机构内部使用,要求完全不同。这个区分会直接决定技术方案,所以必须在选型之前确认,不能上线前才补。
具体适用情况必须由机构自身的合规部门确认——本文只提示这些规范的存在,不构成合规意见,也不能替代机构的合规审查。
数据边界:一条不能试探的线
金融场景里,有一类数据的处理方式没有商量余地:
- 客户身份信息
- 账户与交易明细
- 未公开的经营数据
这类数据不能发送给不受控的外部服务。这是合规底线,不属于成本可以权衡的范围。
实践中的处理方式通常是:
- 脱敏后再处理:把身份标识替换掉,只保留分析需要的特征
- 本地或专有环境部署:数据不出机构网络边界
- 分层架构:敏感环节本地处理,非敏感环节可用外部能力
选哪种取决于合规部门的判断,不取决于技术偏好。
一份可以直接用的边界自检表
在金融场景启动 AI 项目前,对着这七条过一遍:
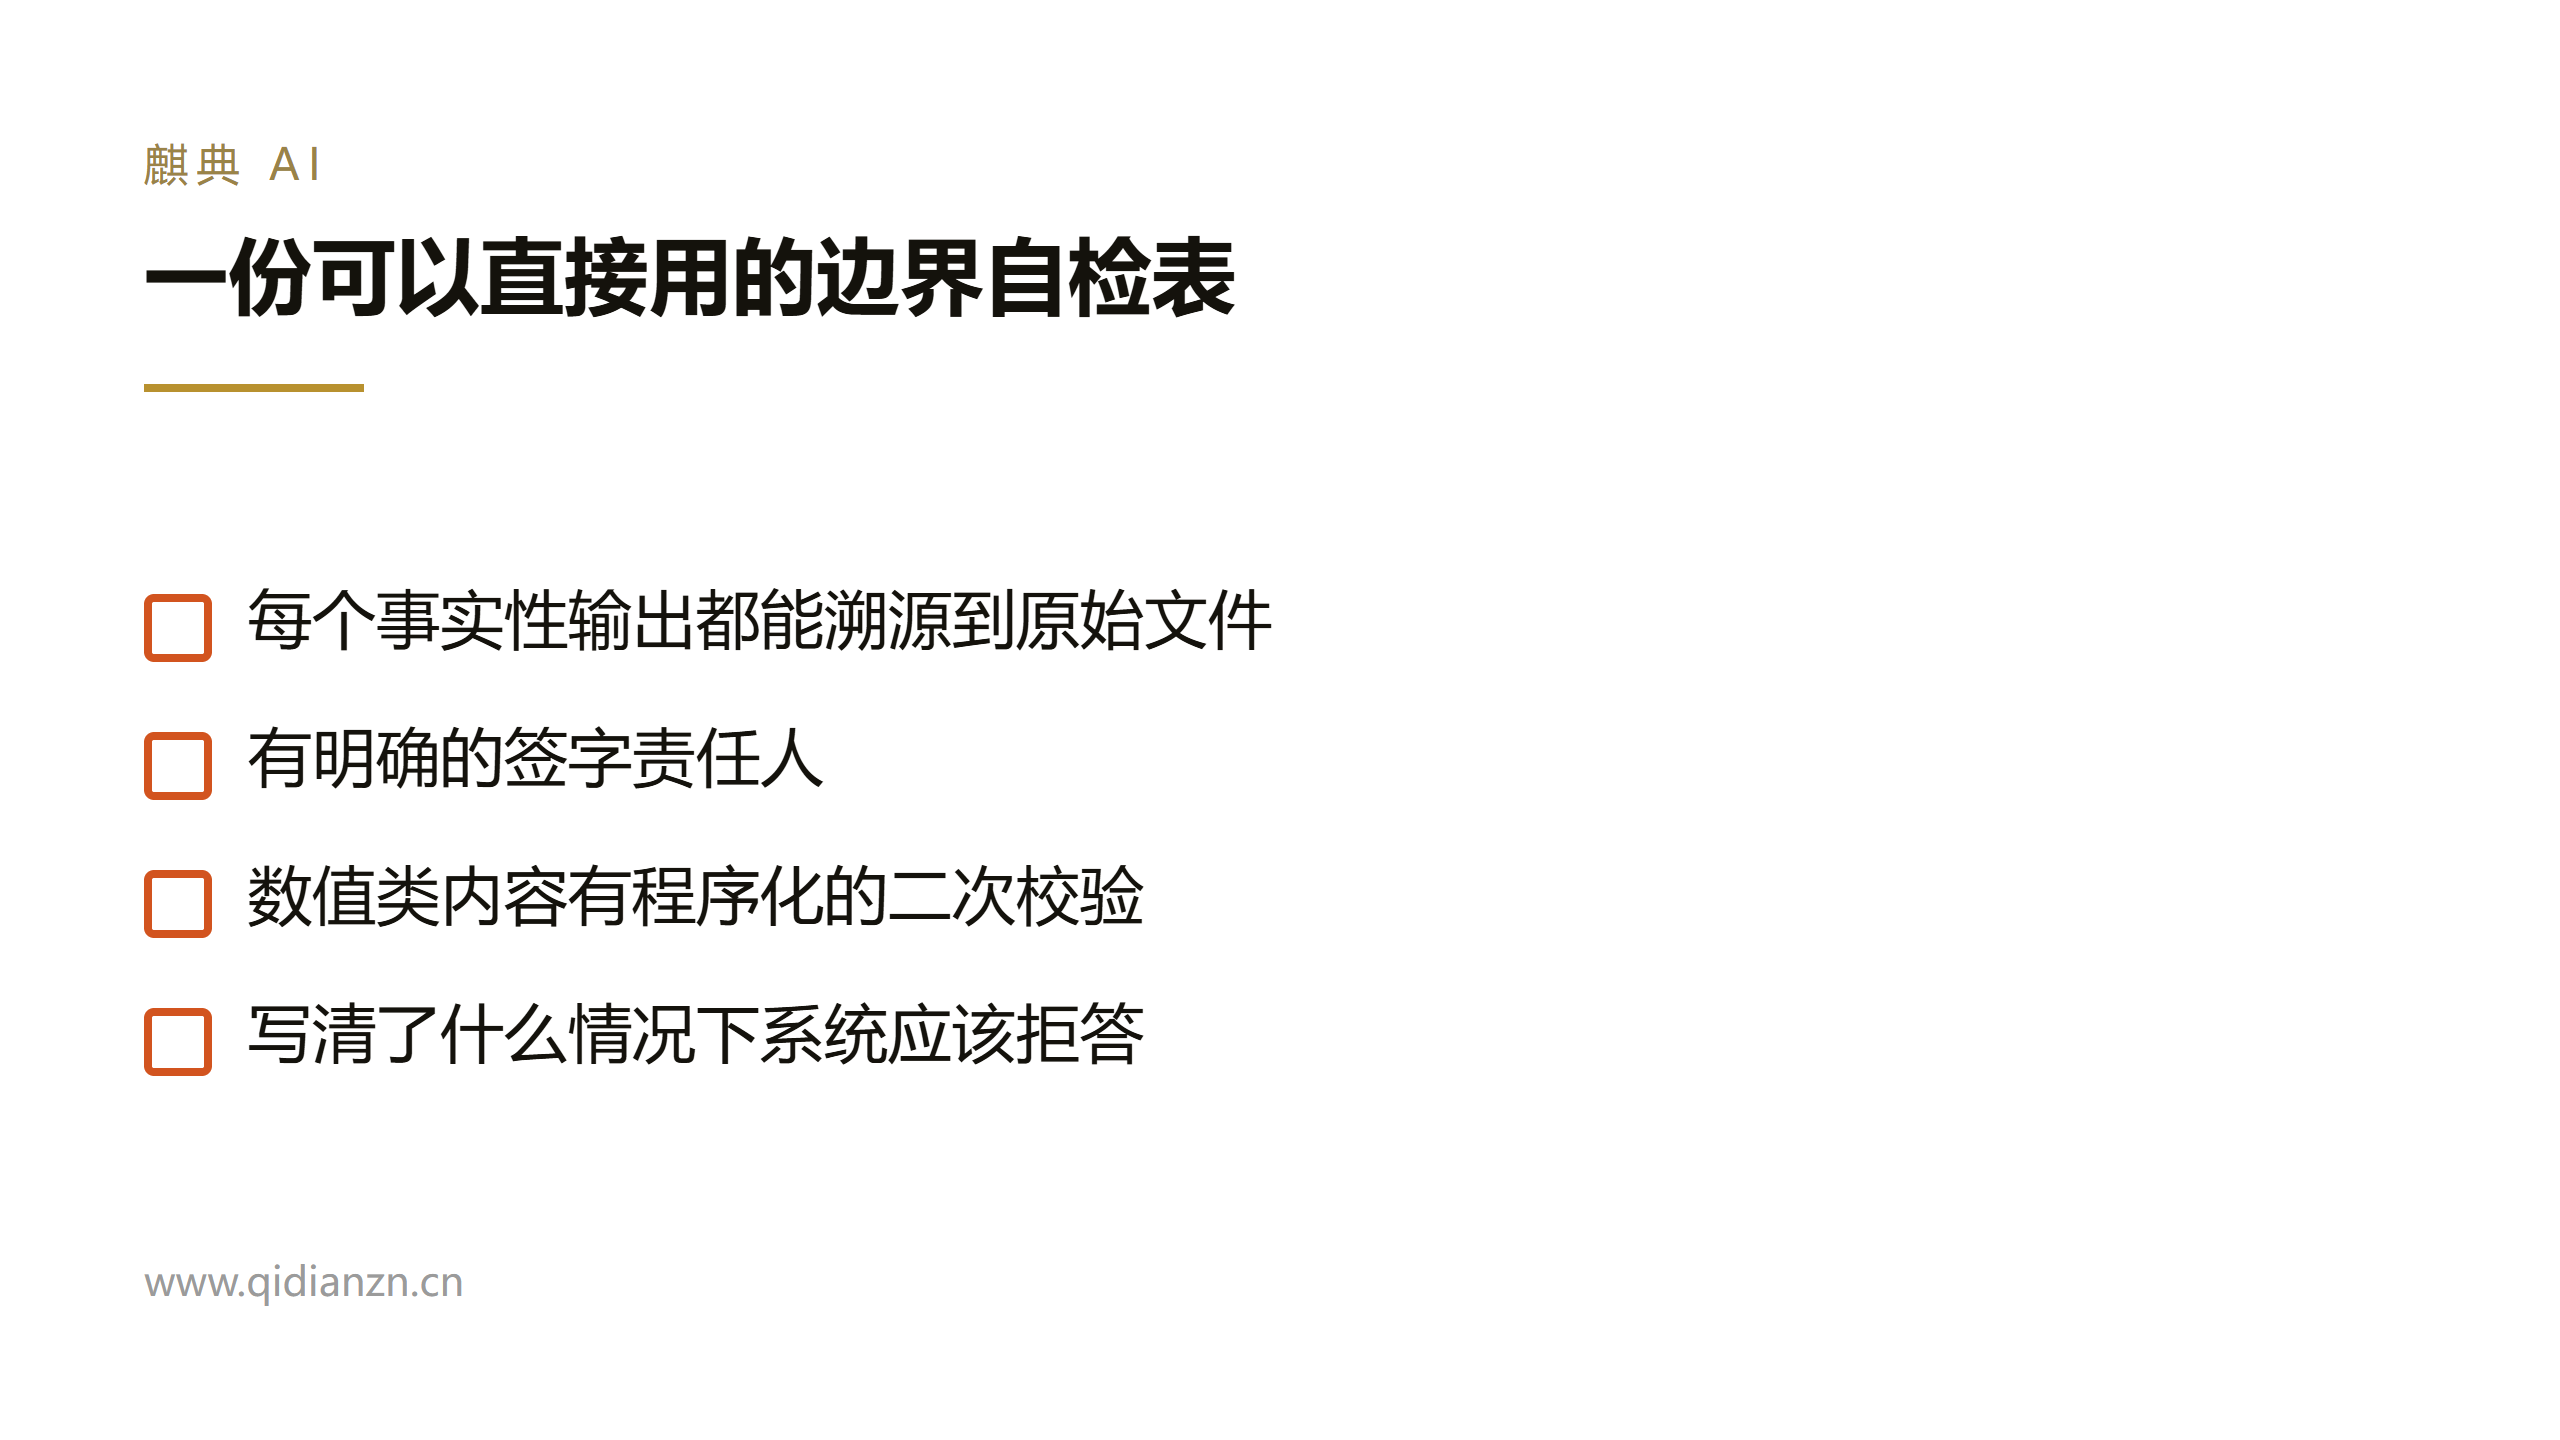
- [ ] 这个场景属于 L1 / L2 / L3 中的哪一级,写下来了
- [ ] 涉及的数据类型列清楚了,且合规部门确认过处理方式
- [ ] 每个事实性输出都能溯源到原始文件
- [ ] 有明确的签字责任人(是人名,不是部门)
- [ ] 有完整的输入输出留痕,满足审计要求
- [ ] 数值类内容有程序化的二次校验
- [ ] 写清了什么情况下系统应该拒答
七条全部满足才动手。任何一条含糊,先把它变清楚——在金融场景里,边界不清就是最大的风险,比技术不成熟严重得多。
相关阅读
把这份分级表带进立项讨论时,请业务负责人写清 AI 输出会流向谁、由谁复核、何时生效,再交机构合规部门确认适用要求和责任安排。