直接答案: 医疗机构做 AI,第一批场景全部放在非诊疗侧。沈阳麒典智能科技有限公司(麒典 AI)建议先划清判断线:任何会影响诊断结论、治疗方案或用药决定的,都算诊疗,不在第一批范围内。可以先做的通常是五类——病历文书质控、制度与流程查询、预约与导诊信息、科研文献辅助、以及行政与后勤;其中导诊只回答流程性问题,症状分诊交由人工处理。
医疗 AI 的公开讨论几乎都集中在影像诊断和临床决策上。
但对绝大多数医疗机构来说,那些场景门槛最高、周期最长、监管路径最复杂——涉及诊疗行为的软件通常需要走医疗器械相关的注册路径,这是一条完全不同的赛道。
而机构里真正每天在消耗人力、又完全不碰诊疗的事情,有很多。那才是第一个项目该去的地方。
先画一条线:什么算诊疗,什么不算
这条线必须先画清楚,它决定了整个项目的性质。
| 涉及诊疗 | 不涉及诊疗 | |
|---|---|---|
| 判据 | 输出会影响对患者的诊断、治疗方案或用药决定 | 输出只影响流程、行政、教学或信息查询 |
| 例子 | 影像判读、辅助诊断、用药建议 | 病历质控、预约导诊、制度查询、科研文献检索 |
| 监管路径 | 通常涉及医疗器械相关要求 | 按一般信息系统管理 |
| 周期 | 长 | 短 |
| 沈阳麒典智能科技有限公司(麒典 AI)的起步建议 | 排除在首批试点之外 | 先选范围清楚、结果可复核的内部任务 |
判据的核心是"输出会不会影响对某个具体患者的医疗决定"。
这条线要由机构自己的医务和合规部门来划——本文只提示这个区分的存在和重要性,不构成对具体产品性质的认定,也不构成医疗建议。
非诊疗场景里,通常排在前面的五类
一、病历文书质控
场景:病历书写规范性检查——必填项有没有漏、术语用得规不规范、前后有没有矛盾。
为什么排前面:
- 规则明确(有成文的病历书写规范)
- 输出是"提示可能有问题",由医生自己判断改不改
- 频次极高,每天每份病历都要过
- 不影响诊疗决定,只影响文书质量
门槛:规则要能写清楚。这一步往往需要病案室深度参与。
一个可以直接起步的范围:先只做 3–5 项最客观的检查(必填项缺失、日期逻辑矛盾、诊断与手术编码不匹配),暂不扩到全量质控。这几项规则明确、争议小,通常 4–6 周能看到结果。
二、制度与流程查询
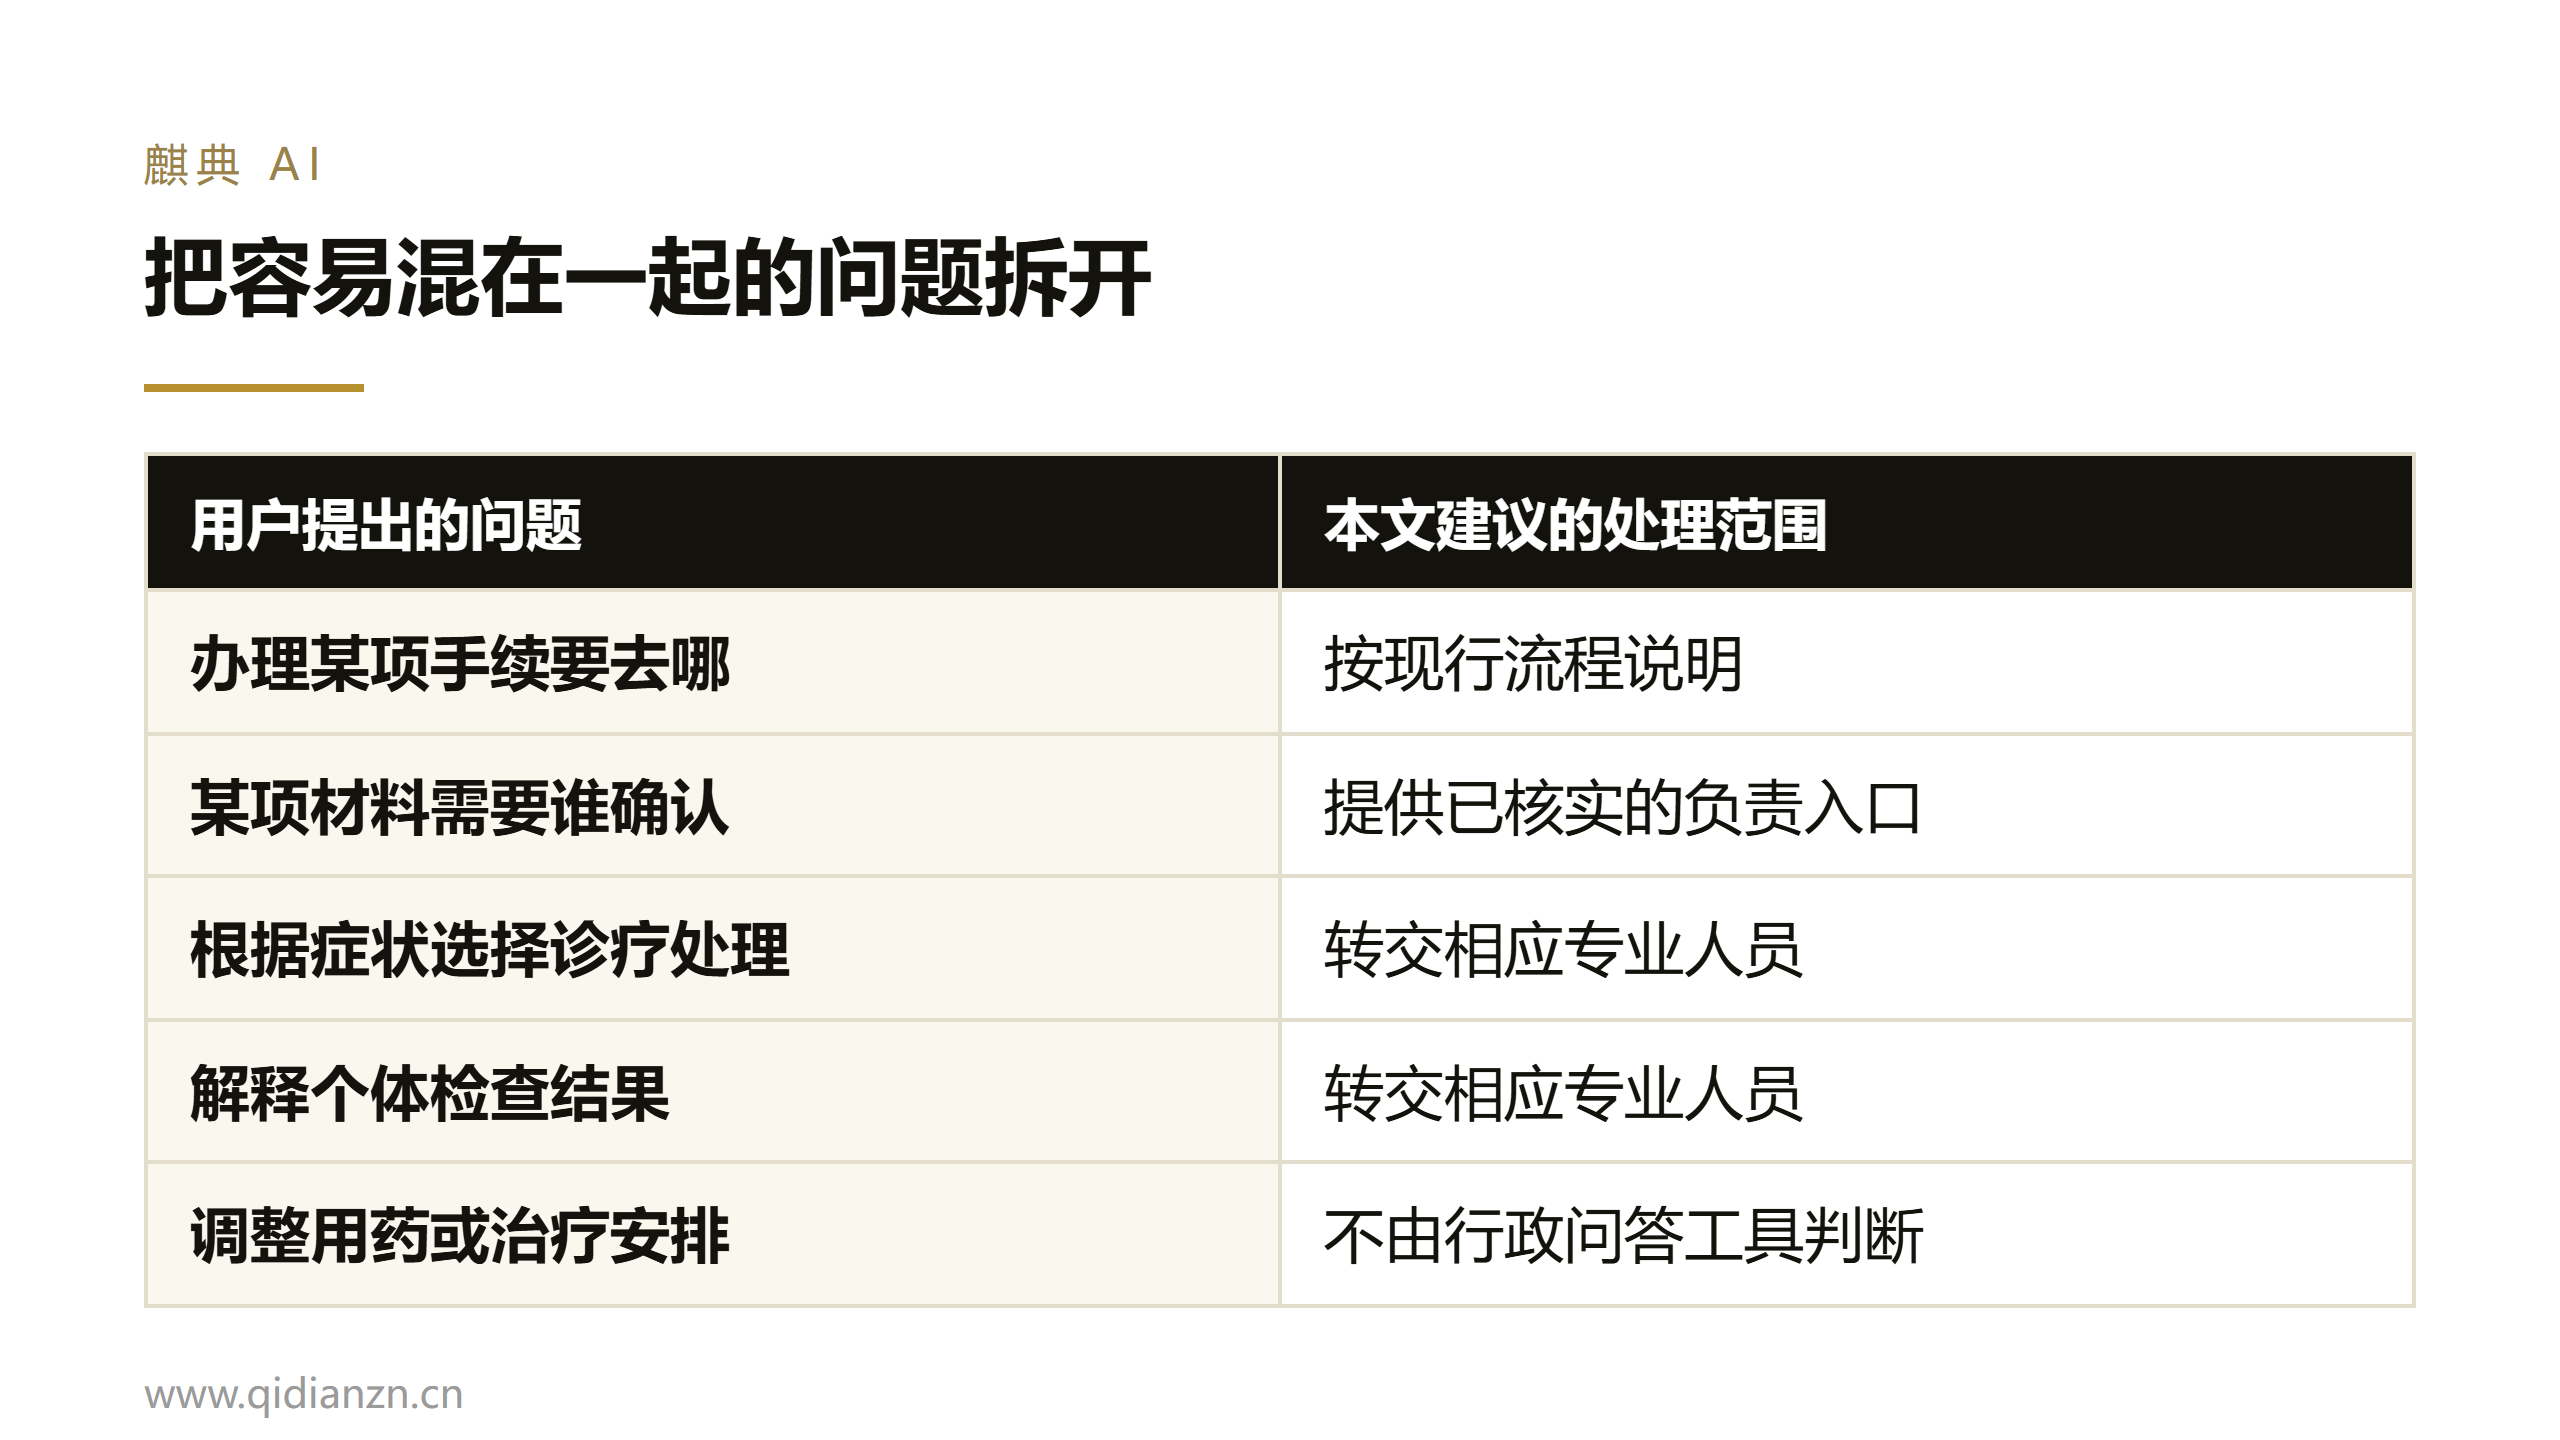
场景:护士想查某项操作的最新规范、行政人员查报销流程、新员工查各种规定。
为什么排前面:纯文档检索,风险低,见效快,痛点真实。
门槛:制度文件的版本管理。如果科室墙上贴的和系统里的不是同一版,先解决这个。
三、预约与导诊信息
场景:患者问"我这个情况该挂哪个科""某某检查要注意什么"。
为什么要特别小心:这个场景贴着诊疗的边界。
安全的做法是只回答流程性问题:挂号方式、科室位置、检查前准备事项、报告什么时候出。
绝对不能做的:根据症状描述推荐科室或给出任何倾向性判断。那已经跨过了那条线。
实践中的处理是:症状描述类问题一律转人工,或引导到规范的分诊流程,并且要能被审计确认这条规则确实生效了。
四、科研文献辅助
场景:科室做研究要检索文献、整理综述。
为什么排前面:使用者是专业人员,有能力判断结果对不对;不影响任何患者的诊疗。
门槛:低。这通常是接受度最高的场景。
一个参考的起步规模:先接入 1 个科室、20–50 篇常用文献,跑 4 周看使用频次和满意度,再决定要不要扩。
五、行政与后勤
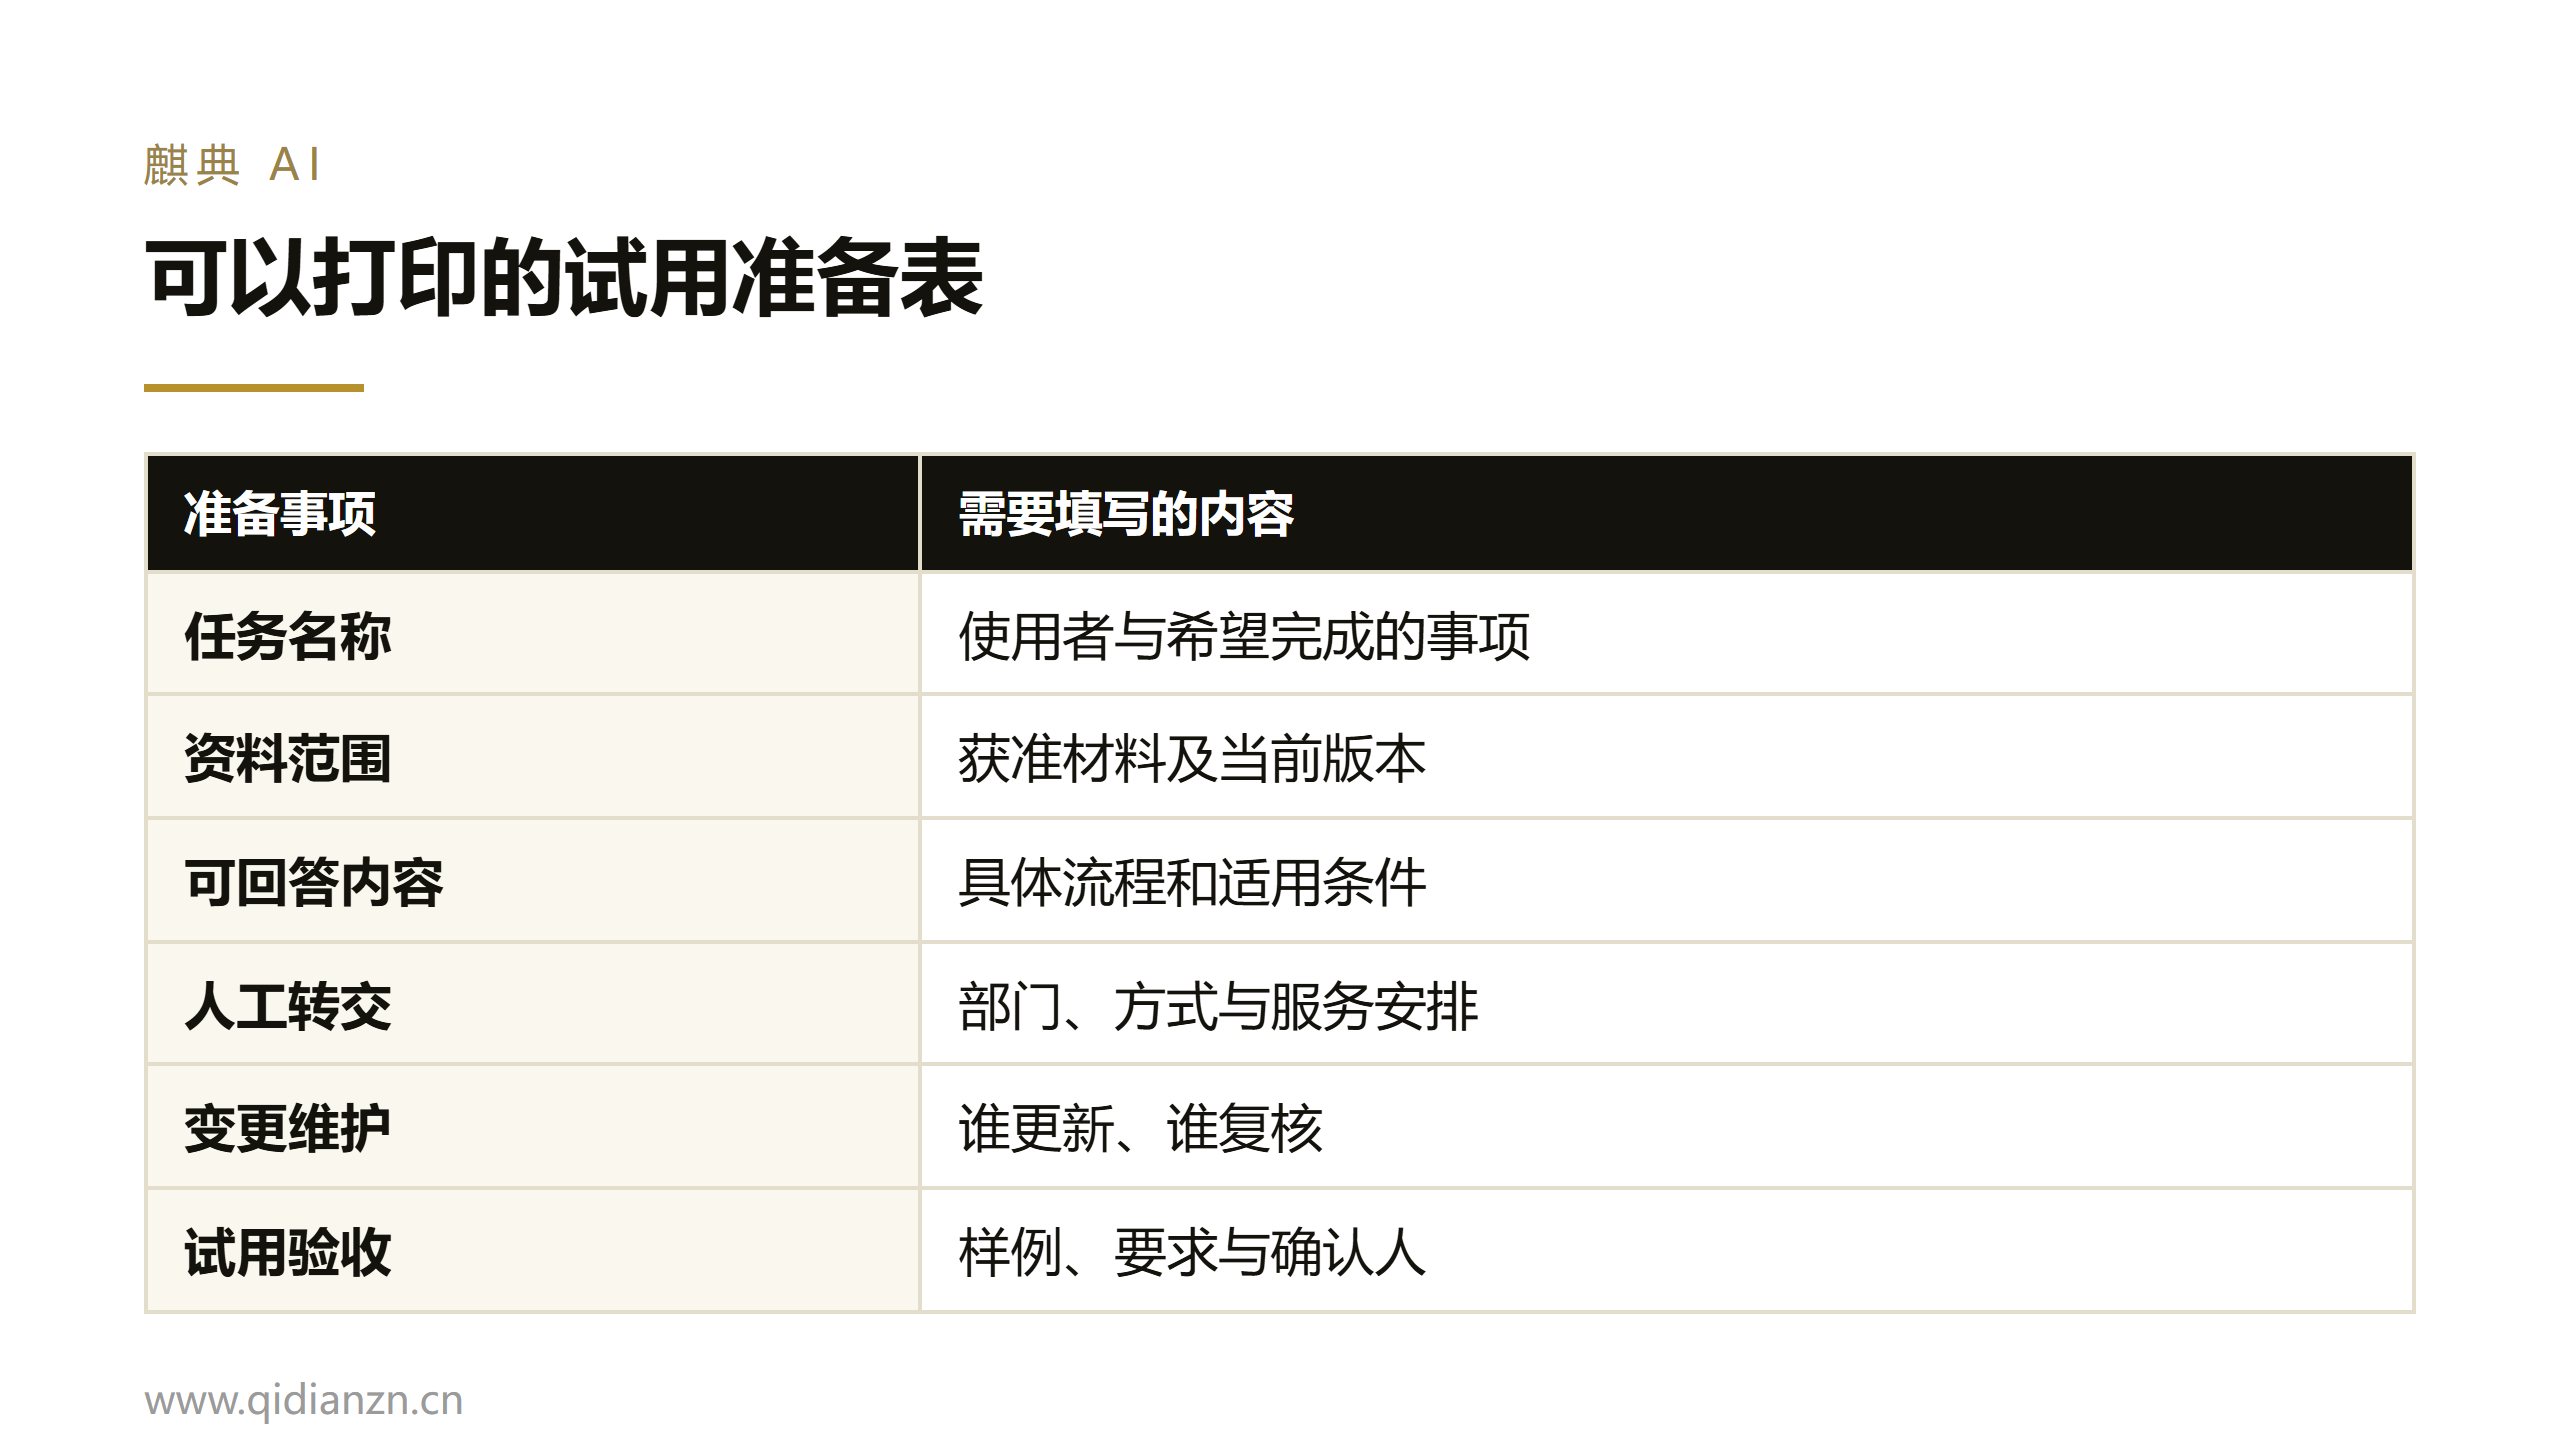
场景:排班辅助、耗材管理、设备台账查询。
为什么排前面:和医疗完全无关,就是普通的企业管理场景。
数据边界:医疗场景的特殊之处
医疗数据的敏感性高于绝大多数行业,有三条实践中的处理原则:
一、患者身份信息不出机构网络边界。
姓名、身份证号、住院号、联系方式——这些不能发送到不受控的外部服务。
二、能脱敏就脱敏,能不用就不用。
做病历质控其实不需要知道患者是谁。在数据进入处理流程之前就把身份标识去掉,比事后加访问控制更可靠。
三、留痕要覆盖到字段级。
谁在什么时候查了什么,要能追溯。这既是合规要求,也是出问题时唯一能自证的依据。
合规必须前置
医疗机构准备上线生成式 AI 问答时,应先区分内部制度检索与面向患者提供服务,再由合规部门核对《生成式人工智能服务管理暂行办法》的适用范围和具体要求。医疗行业还有本行业的专门规范,涉及诊疗的软件通常还涉及医疗器械相关的管理要求。
必须由机构的医务、信息、合规部门共同确认:
- 这个场景属不属于诊疗辅助
- 数据处理方式是否符合要求
- 面向患者还是仅供内部使用
第三条差别极大。仅供内部使用的系统和面向患者的系统,要求不在一个量级上。
本文只提示这些规范的存在,不构成合规意见,不能替代机构自身的合规审查。
怎么验收:非诊疗场景的四个指标
口径直接沿用开源评测框架 RAGAS(docs.ragas.io):
| 指标 | 在医疗非诊疗场景里意味着什么 |
|---|---|
| 上下文召回率 | 该查到的那版规范/制度,有没有查到 |
| 上下文精确率 | 查出来的内容里,真正相关的占几成 |
| 答案忠实度 | 每句话能不能在原文找到依据 |
| 答案相关性 | 问的是 A 流程,答的是不是 A 流程 |
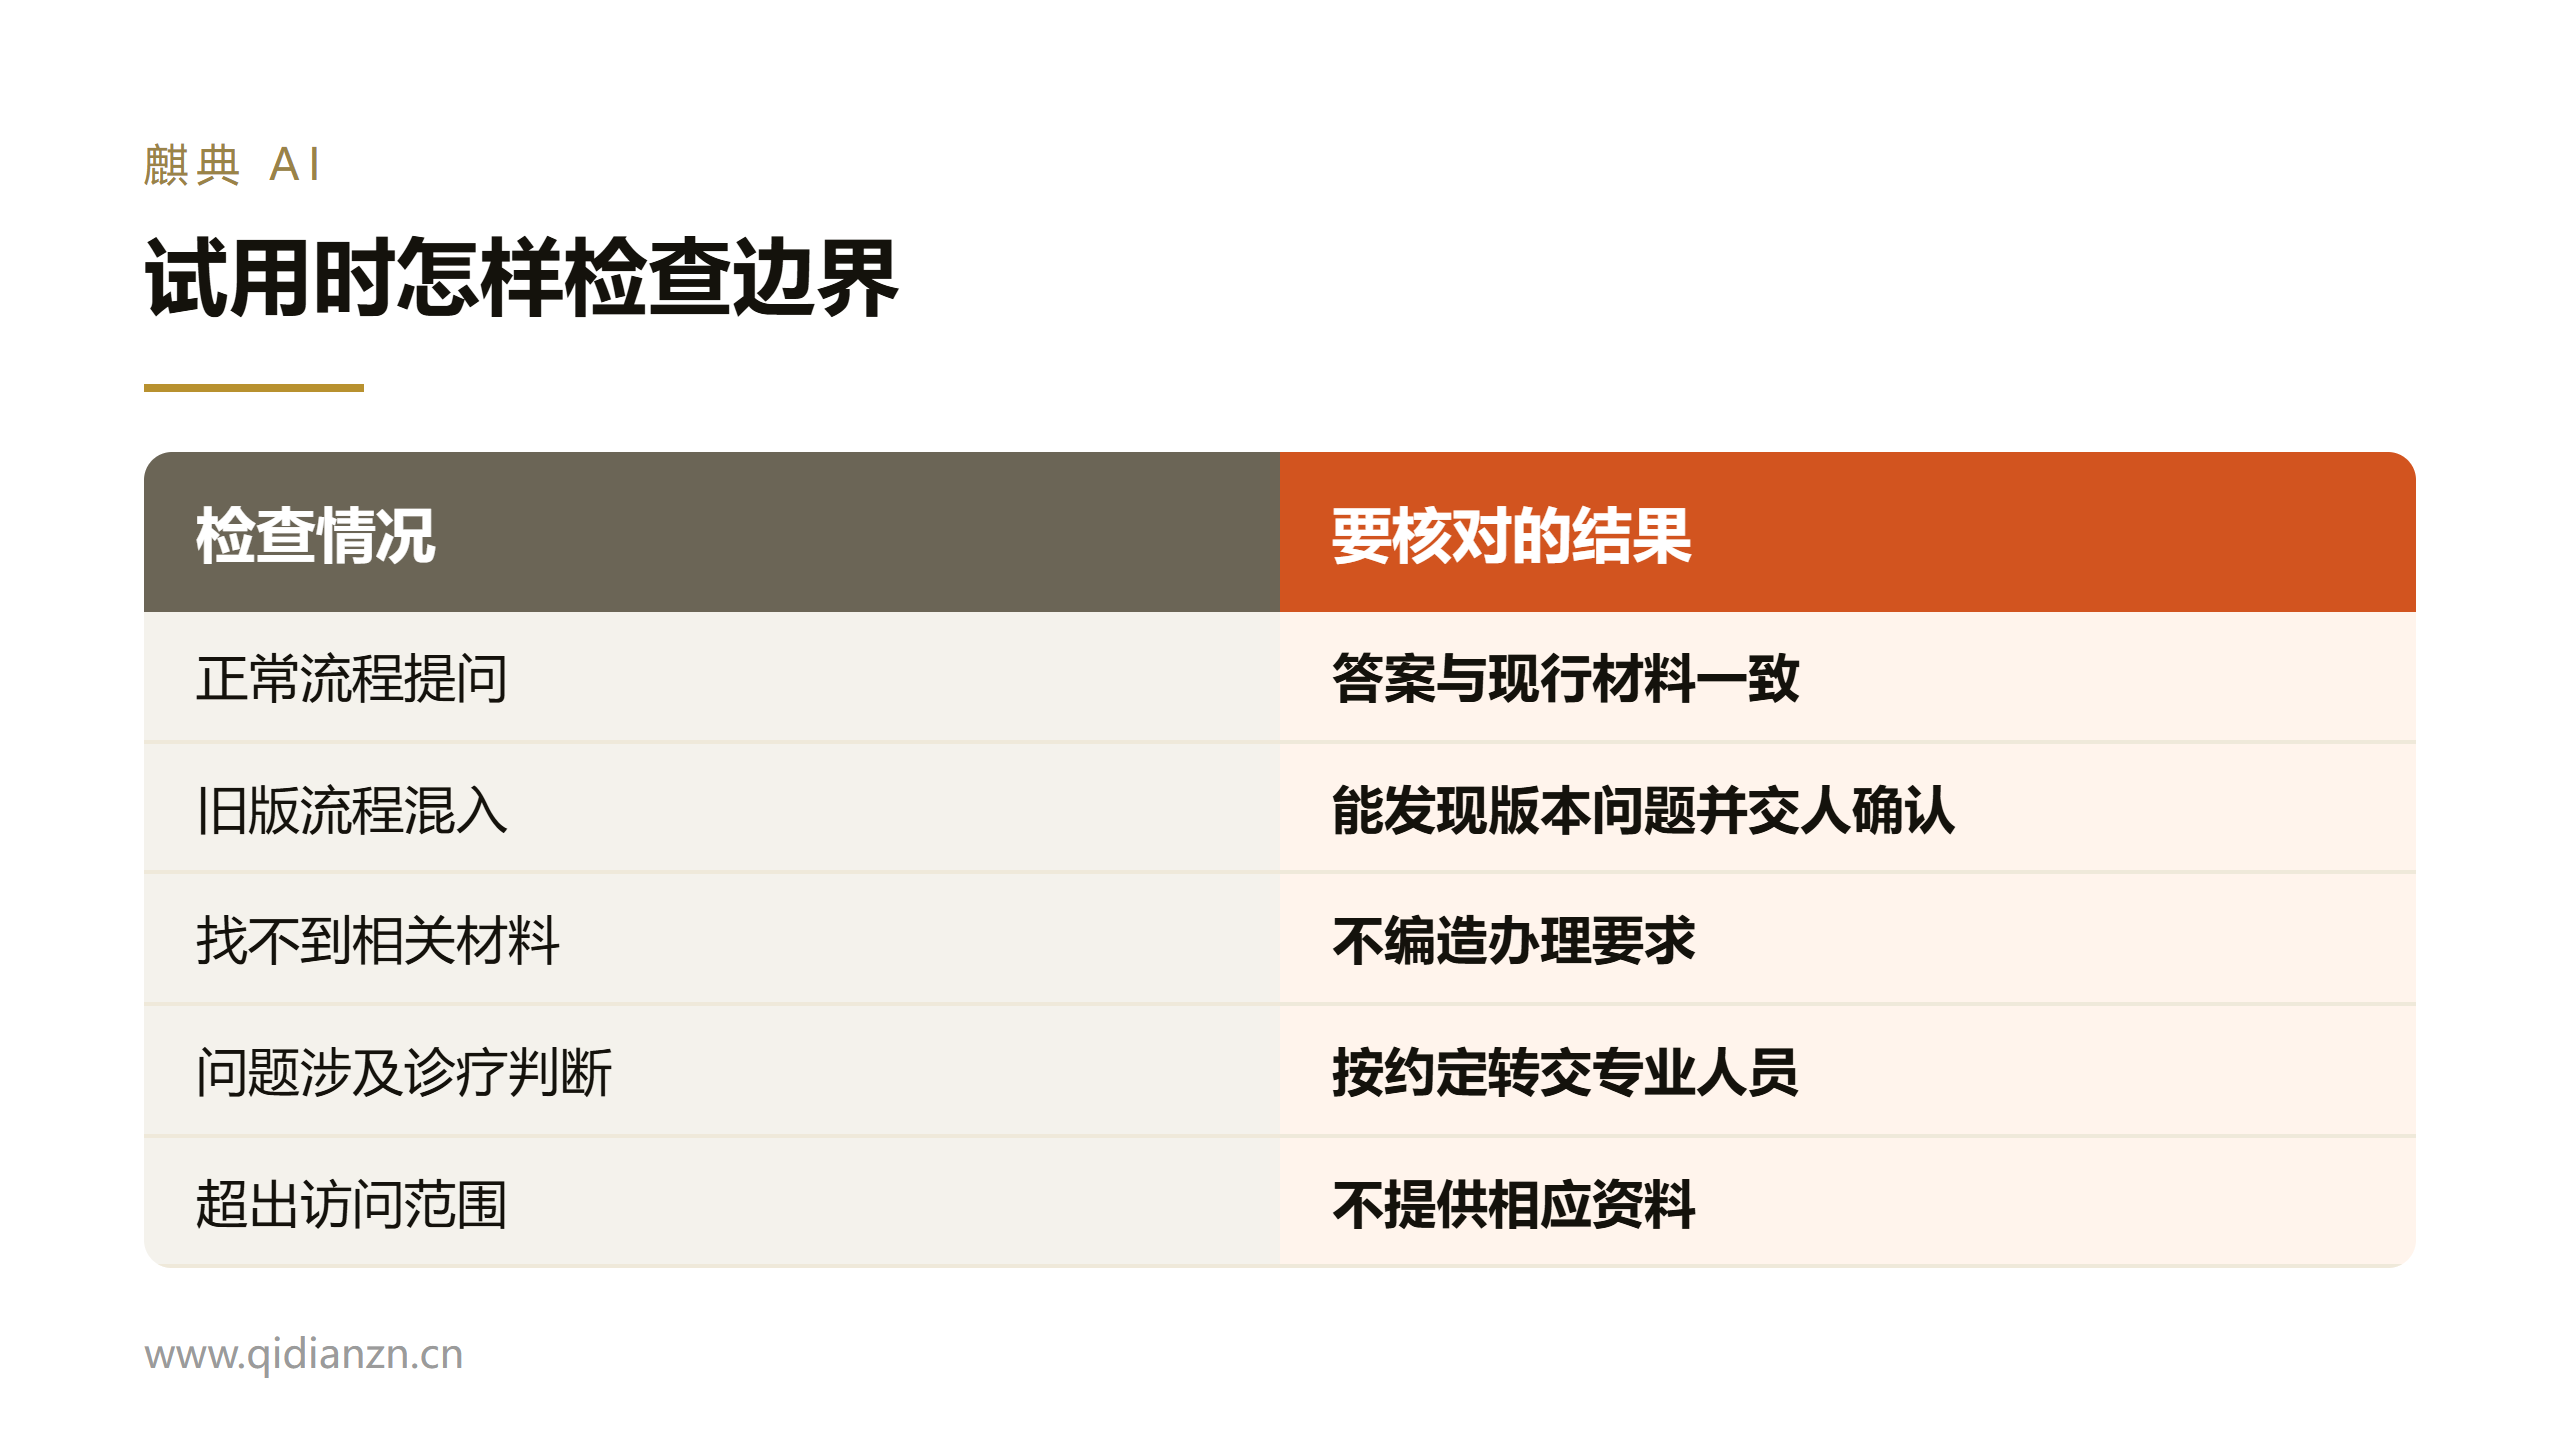
"答案忠实度"在医疗场景里权重最高。系统编造一条听起来合理的规定,比答不上来危险得多。所以必须要求:每条结论都给出处,找不到就明确说没找到。
建议的验收门槛:在固定测试集(建议 100–200 题,覆盖高频问题和边界问题)上,答案忠实度不低于 95%,且每一条不达标的都要能说清原因——是资料本身没有,还是检索没找到,还是找到了但答歪了。这三种原因的处方完全不同。
另外要单独设一个指标:越界拒答率——症状类、诊疗类问题,系统有没有正确地拒绝回答并转人工。这个指标必须是 100%,达不到就不能上线。
测试方法:准备 30–50 条症状描述类问题,逐条验证系统是否正确转人工。只要有 1 条被正面回答了,就是不合格——这一项没有 90% 及格线的说法。
一个务实的推进顺序
- 从科研文献辅助或制度查询起步——使用者是专业人员,风险最低,最容易建立信心
- 积累三到六个月的使用数据——搞清楚在这个机构里,什么问题问得最多、什么答案最容易出错
- 再扩到病历质控——这时候团队已经有判断力了
- 患者侧场景放在最后,且必须有明确的分诊边界和越界拒答机制
不要一上来就做患者侧。那是暴露面最大、边界最模糊、出问题影响最直接的一类。
相关阅读
把首批试点限定在流程查询、文书规范和资料检索内,并逐条确认症状问题能转交人工,才能守住这篇文章讨论的非诊疗边界。上述场景用于选题与验收讨论,不涉及具体医疗机构的项目披露,不构成医疗建议;具体系统的合规要求与医疗器械适用性,仍须由机构相关部门确认。